2026年5月7日以降、Microsoft Foundryはクォータ(利用枠)の管理を、リソース単位・リージョン単位からサブスクリプション単位へ順次移している。Realtime TranslateとRealtime Whisperから始め、いずれ全モデルに広げる予定だ[2]。
プールという言葉は、429エラー(Too Many Requests)の説明にも出てくる。ただしそちらは従量課金のデプロイが顧客をまたいで共有する処理基盤のことで、自社サブスクリプション内のクォータプールとは別物だ[1][2]。Microsoft Learnのクォータ管理ガイド[1]は429を4つの類型に分けており、クォータの割当や増枠が対処になるのは、そのうちレート制限の超過だけだ。ガイドは、容量に由来する429を多くの顧客がクォータの問題と取り違え、一時的な容量逼迫に増枠申請で応じるような誤った対処をしていると注意している[1]。
予備知識
- TPM/RPM: 1分あたりのトークン数/リクエスト数の上限。RPMはTPMの割当に比例して決まる。
- クォータ: サブスクリプションに割り当てられたTPMの枠。デプロイメントごとに配分して使う。
- データゾーン: Microsoftが定める推論データの処理範囲。米国・EU・アジア太平洋(APAC)がある。
- PTU(Provisioned Throughput Unit): 専用の処理容量を予約するデプロイ方式の単位。
書名のとおり、Azure OpenAI Serviceを組み込んだシステム構築を扱う実践書。429の切り分けは、構築したシステムを運用する段階で出てくる論点にあたる

クォータプールはサブスクリプション単位へ移りつつある
[1]の説明では、クォータはサブスクリプションに対し、リージョン・モデル・デプロイタイプごとにTPM単位で割り当てられる。デプロイメントを作るときにTPMを割り当てると、そのモデルの残りクォータがその分だけ減る[1]。サブスクリプションとリージョンの範囲でTPMを配分できるようになったことで、リージョンあたりのリソース数の上限は30に引き上げられ、1つのリソースに同じモデルのデプロイメントを1つしか作れない制限もなくなった。割当の変更や増枠申請は、反映まで最大15分程度かかる[1]。2026年5月からの移行では、リージョンという区切りも外れる。Global Standardでは同じモデル・バージョンのデプロイメントがサブスクリプション内の全リージョンで1つのプールを共有し、Data Zone Standardではデータゾーン(米国やEUなど)ごとに1つのプールを共有する[2]。
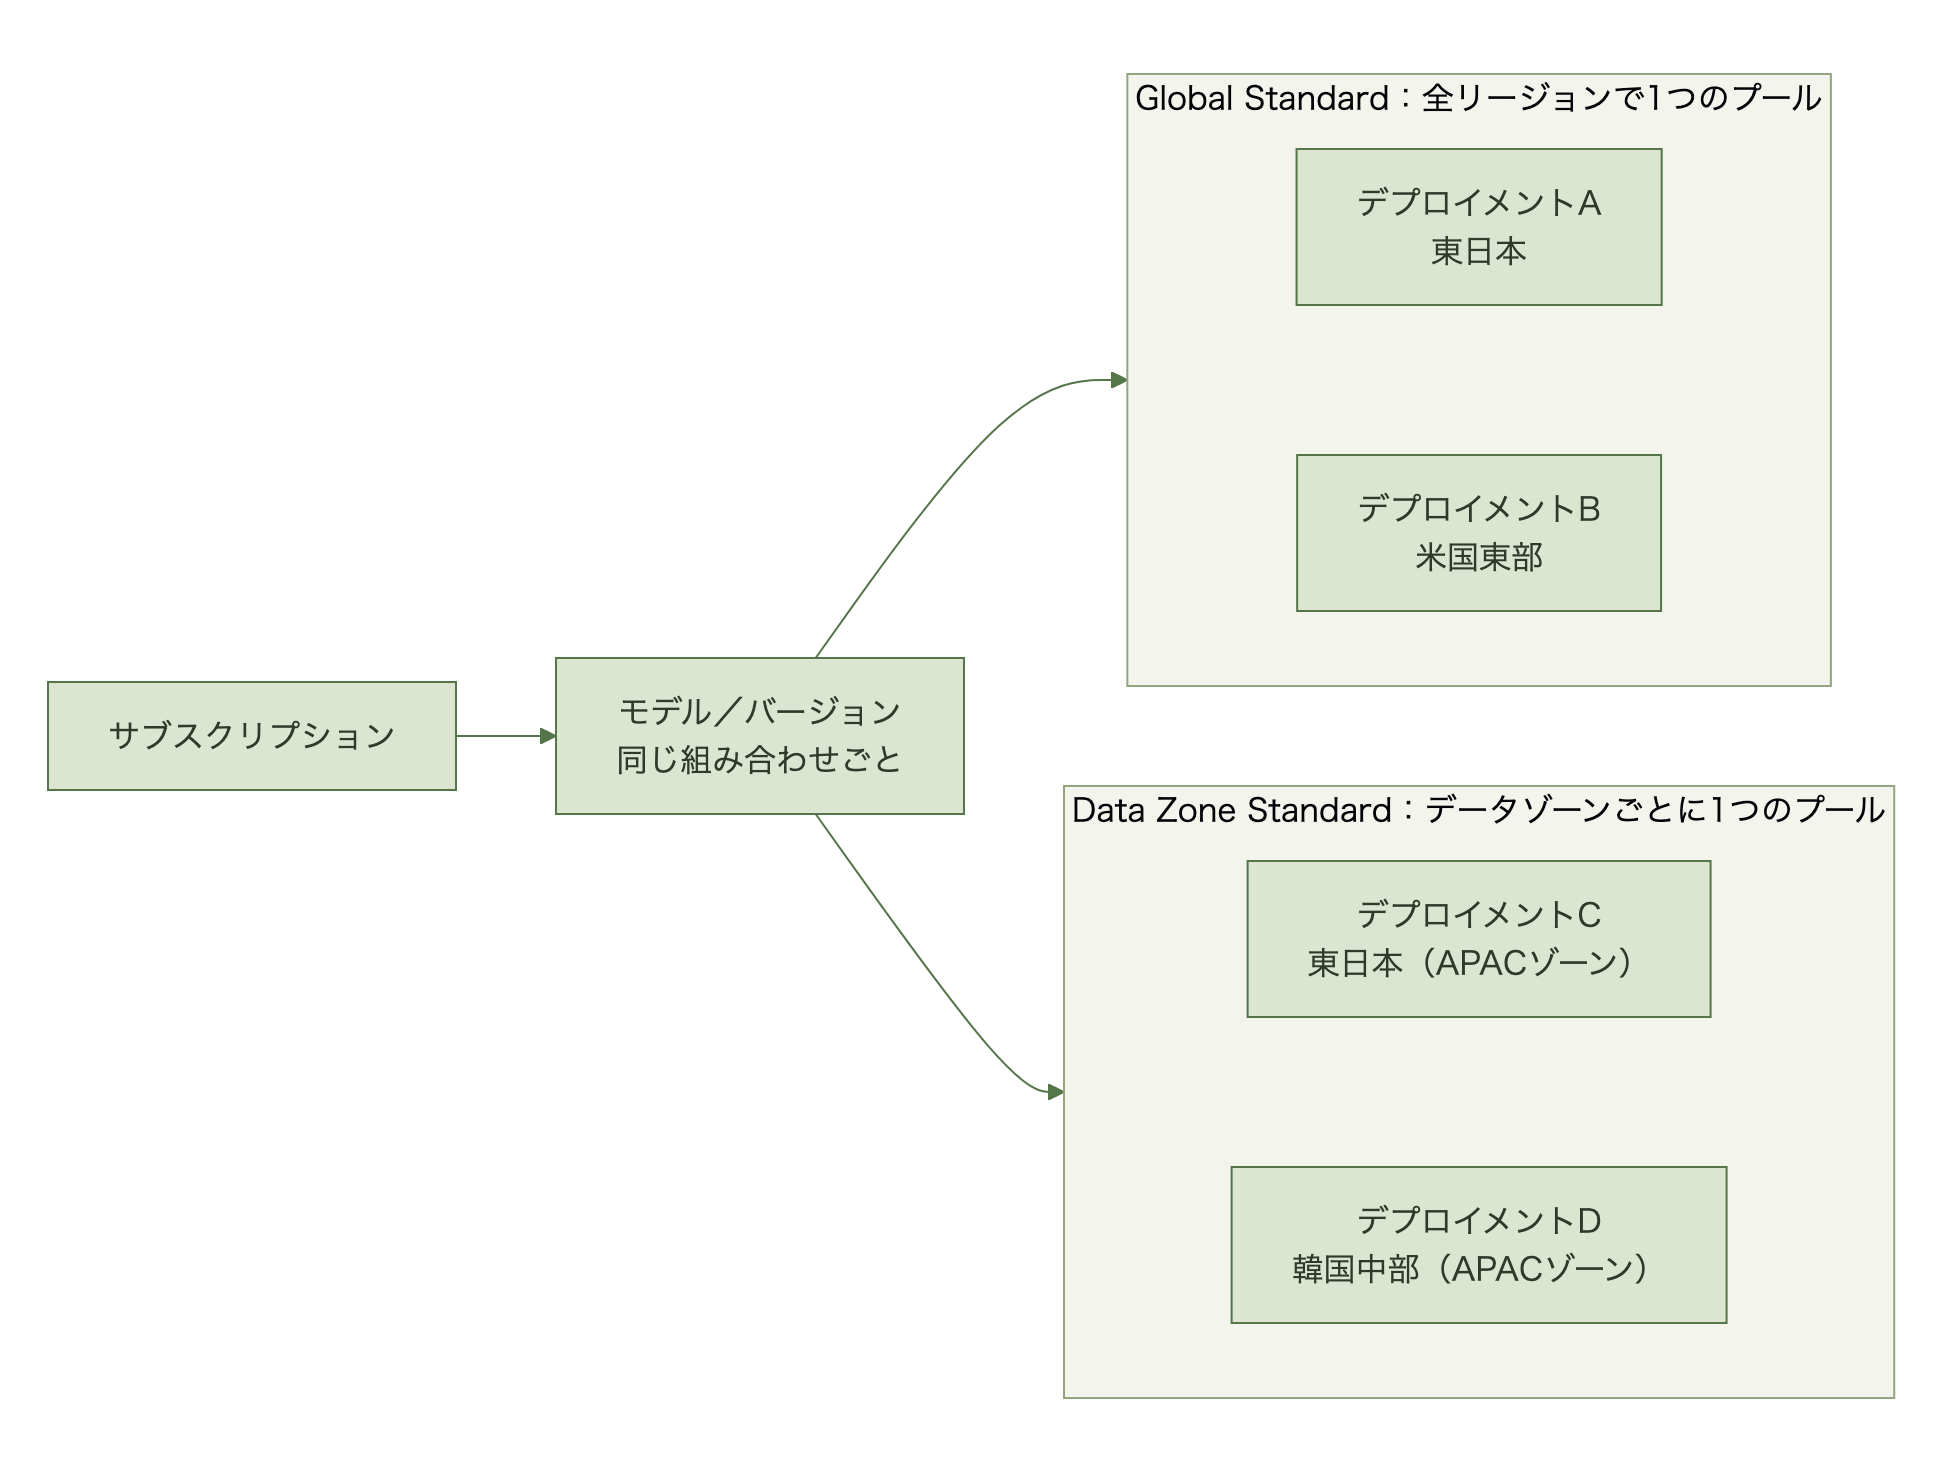
プールが大きくなっても、レート制限がかかる単位はデプロイメントのままだ。デプロイメントに割り当てたTPMがそのままTPM制限になり、RPM制限もその割当に比例する[1]。[1]は、サブスクリプションのクォータが承認済みでも、トラフィックを受けるデプロイメントに割り当てていなければ429になるとして、デプロイメント単位の割当を確かめるよう求めている。
429の原因切り分けのような監視体制の整備を、個別製品知識でなく運用設計の型として押さえたい担当者向け

429を起こすもう一つのプール
従量課金(Standard)のデプロイは、顧客をまたいで共通のリソースプールを使う。システムはこの共有プールの需要を監視し、あるデプロイメントの需要が容量の上限に近づくか超えると、そのデプロイメントの実効レート制限を一時的に下げる[1]。その間は普段なら通るリクエストにも429が返るが、設定したクォータは変わらない。調整はトラフィックが落ち着けば通常数時間以内に解消し、きっかけとして最も多いのは高負荷のバーストが続くことだという[1]。
見分ける手がかりはレスポンスヘッダのx-ratelimit-limit-tokensで、そのデプロイメントで1分あたりに許されるトークン数を返す。この値が設定したTPMより低ければ、調整が起きている[1]。
| 項目 | クォータプール | 共有リソースプール |
|---|---|---|
| 共有する範囲 | 自社サブスクリプション内のデプロイメント | 従量課金のデプロイを使う顧客全体 |
| 動かすのは | 自社(デプロイメントごとにTPMを割り当てる) | Microsoftのシステム(逼迫時に実効上限を下げる) |
| 設定クォータの表示 | 割当を変えれば変わる | 調整中も変わらない |
| 効く対処 | TPM割当の増加・配分の見直し・増枠申請 | retry-after-msに従う再試行、続くならPTU |
表の内容は[1][2]による。右の列の429に増枠申請で応じるのが、[1]が挙げる誤った対処の典型だ。
数千人規模でAzure MonitorとDatadogを併用し、年次のコスト監査で監視ツール契約の妥当性を問われる企業のITインフラ担当者は、今回の発表を無視できない。対象はマイクロソフトのAzure Monitor、具体的にはSLI(サ[…]

4つの類型をメッセージとヘッダで切り分ける
[1]は、対処の前に必ずエラーメッセージとレスポンスヘッダで原因を確かめるよう求め、類型ごとの手がかりを示している。- レート制限の超過:
Rate limit is exceededなどのメッセージ。割り当てたTPMかRPMの上限を超えた状態で、クォータの操作が効くのはこの類型だけだ。 - システム容量のスロットリング:
The service is temporarily unable to process your requestなどのメッセージ。バックエンドの容量逼迫で、多くは一時的だ。 - 一時的なレート制限調整: 設定クォータは変わらないのに429が出て、
x-ratelimit-limit-tokensが設定TPMより低い。前節の共有リソースプールによる調整だ。 - トークン予算の超過: レート制限に当たっているのに、トークン使用量の指標は低い。レート制限の計算には、プロンプトの推定トークン数と、応答の上限として指定するmax_tokensが入るためだ。
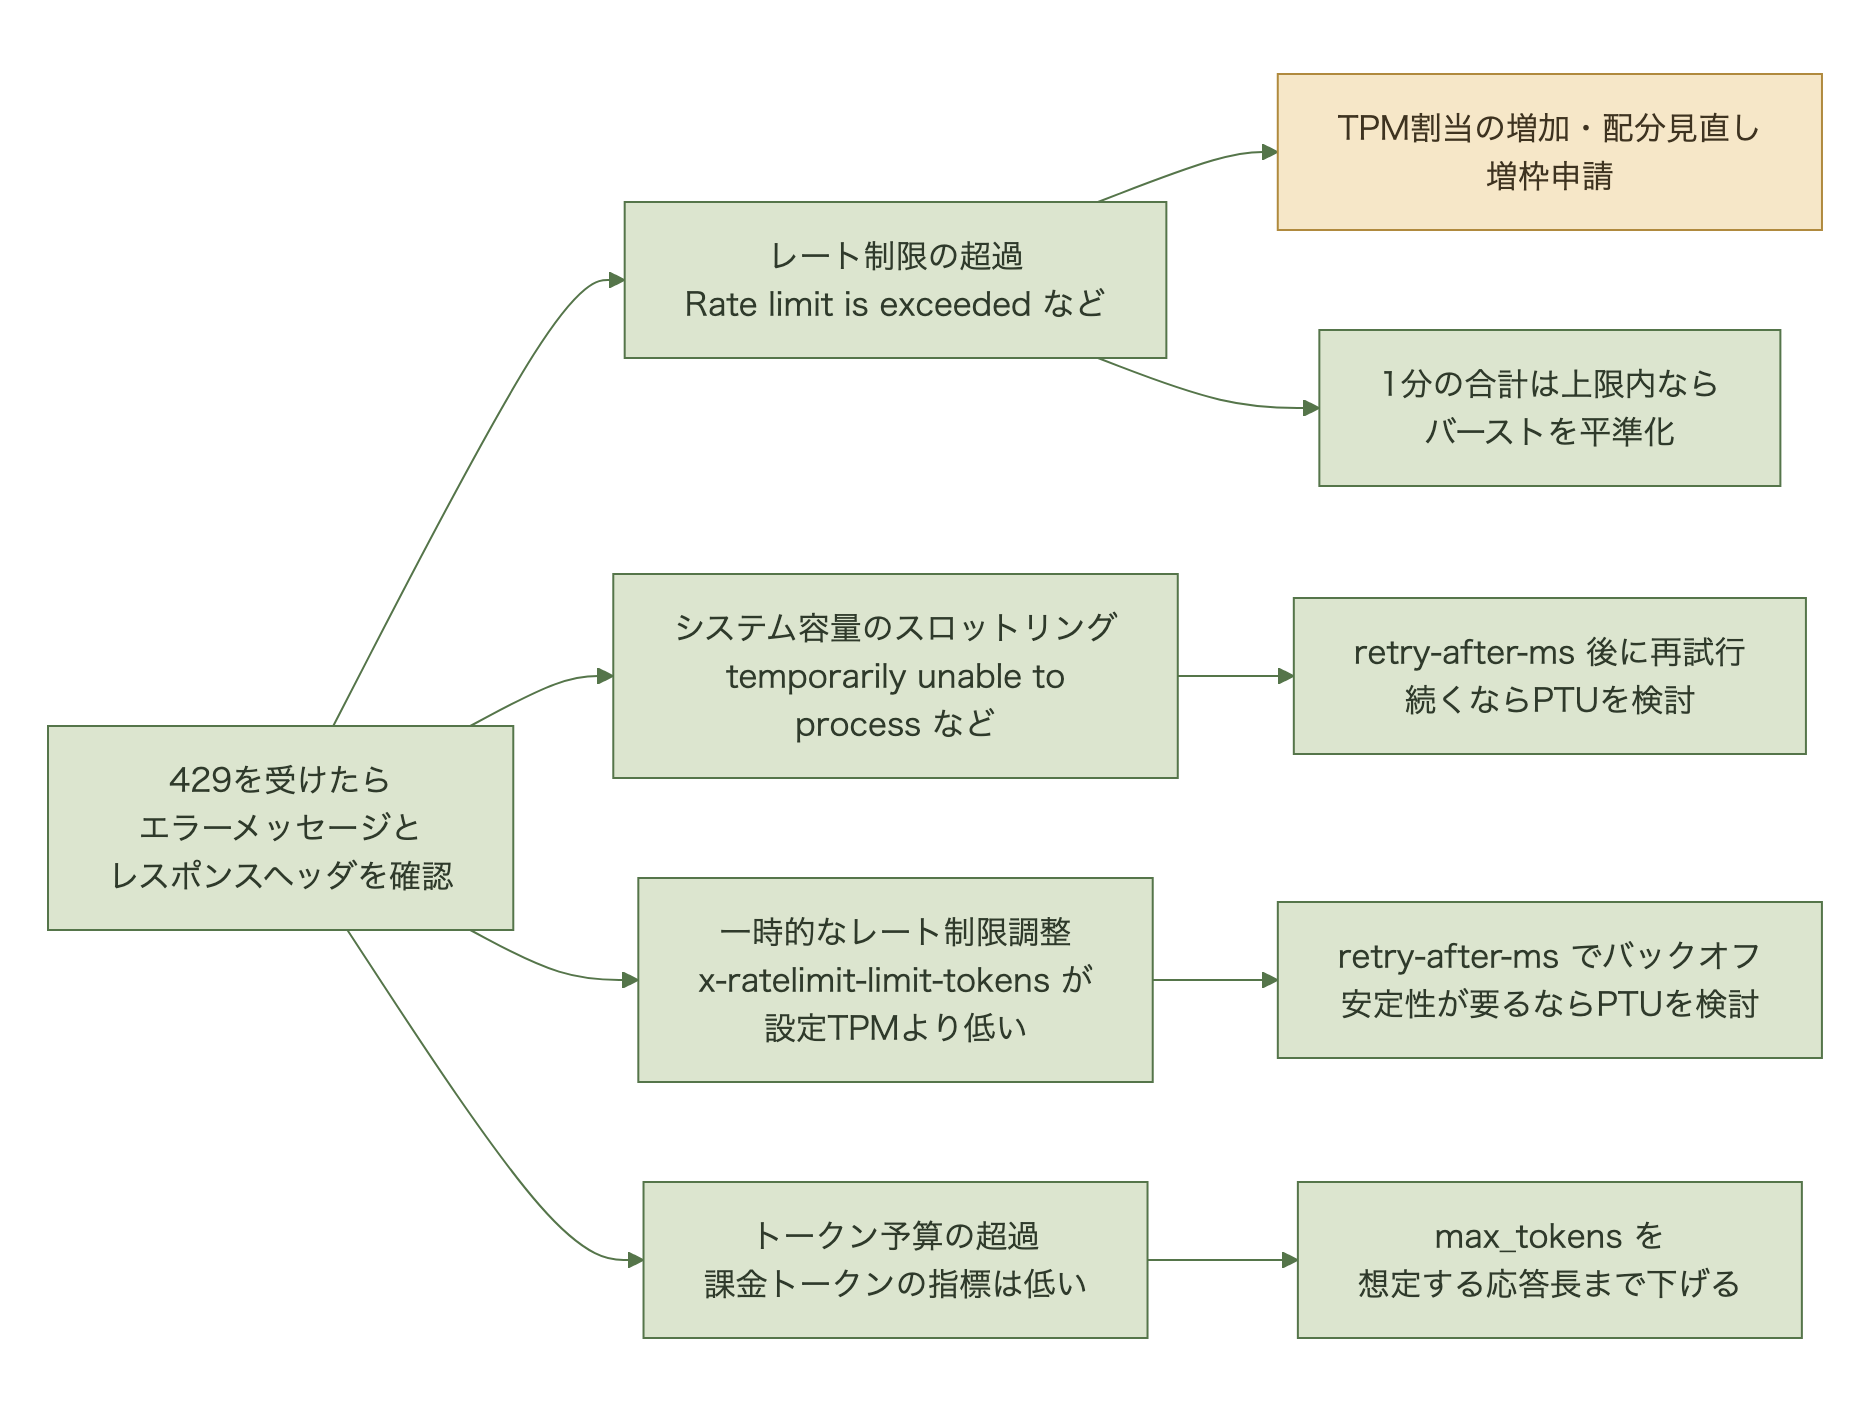
使用量が上限に届いていないのに429が出る理由として、[1]はほかに3つを挙げる。入力長の上限で拒否されたリクエスト(HTTP 400)もレート制限には数えられうること。RPMは1〜10秒の短い窓で評価されるため、1分の合計が上限内でも短時間に集中すれば429になること。レート制限の判定は分散した基盤で行われるため、厳密に一致するとは限らず、集計したメトリクスにもすぐには反映されないこと。1秒単位で評価している場合、600 RPMのデプロイメントは1秒間に10件を超えると制限される[1]。Azure Monitorのトークン使用量は課金されたトークンを示すので[1]、そのグラフが上限の手前にあっても、レート制限による429が起きていないとは言えない。
数百〜数千人規模で社内向けAIチャットボットやエージェントをAzure OpenAI Assistants API(会話履歴やツール呼び出しの状態管理をAzure側が肩代わりするAPI)上に構築し、内部統制上の変更管理プロセスを経て本番投[…]

RPMはTPMに比例するが、比率はモデルで大きく違う
TPMを割り当てるとRPMも比例して決まるが、その比率はモデルごとに違う。プログラムでのデプロイや増枠申請では、TPMとRPMを別々に指定できず、両方が容量ユニット単位で決まる[1]。[1]の容量ユニット表を1,000 TPMあたりのRPMに換算すると次のとおりだ。
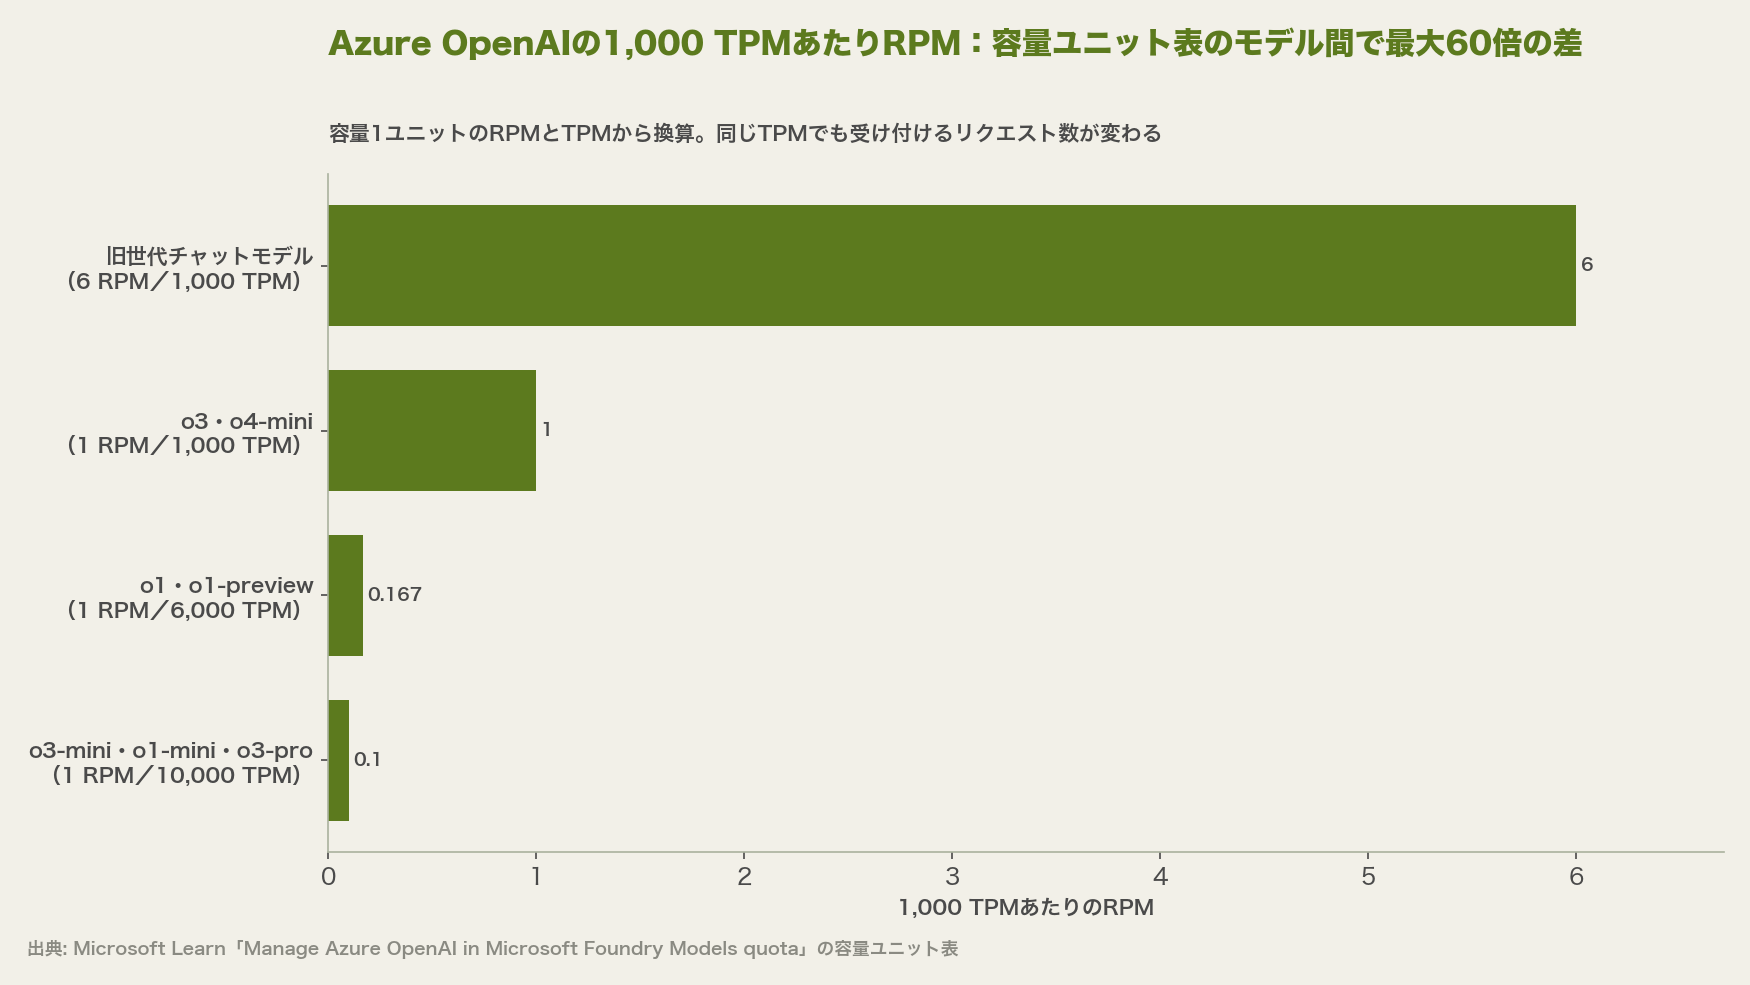
同じ100,000 TPMでも、旧世代チャットモデルなら600 RPM、o3-miniなら10 RPMになる。後者はトークンの消費が上限から遠くても、リクエスト数の上限に先に当たる。[1]はこの比率の違いを、プログラムでデプロイする際にクォータの配分ミスを招きうる点として挙げている。
比率は同じモデル名のバージョン間でも変わる。[2]のクォータ階層表では、gpt-chat-latestの2026-05-05・2026-05-28・2026-06-24版が1,000 TPMあたり10 RPM、2026-08-06版は1 RPMだ。TerraformやBicepでデプロイメントを定義しているなら、モデルやバージョンを上げる変更のレビューでRPMへの換算も確かめたい。
東日本リージョンから見たデプロイタイプとデータゾーン
Azureの日本のリージョンは、東京・埼玉の東日本(japaneast)と大阪の西日本(japanwest)で、地理区分(geography)はどちらも日本だ[5]。リージョン別の提供表[4]では、Data Zone StandardのAPACに東日本が、オーストラリア東部・韓国中部・東南アジア・インド南部と並んで載っている。APACのData Zoneデプロイでは、プロンプトと応答はアジア太平洋のいずれかの国で処理され[4]、Microsoftは事前の通知なくデータゾーンにリージョンを追加できる[3]。Data Zone Standardのクォータプールはゾーンごとに1つなので[2]、サブスクリプション単位の管理が対象モデルに及べば、東日本のデプロイメントは、韓国中部などに置いた同じモデル・バージョンのデプロイメントと枠を分け合う。
処理を日本国内に閉じるなら、選択肢は顧客が指定した地理区分の中で処理するStandard(リージョン)とRegional Provisionedになる[3]。ただし東日本で提供されるモデルは、デプロイタイプで大きく違う。
| 推論データの処理範囲 | 従量課金 | 予約(PTU) |
|---|---|---|
| 任意のAzureリージョン | Global Standard:37件 | Global Provisioned:24件 |
| APACデータゾーン内 | Data Zone Standard:5件(gpt-5.2、gpt-5.3-codex、gpt-5.4、gpt-5.4-mini、gpt-5.6-sol) | Data Zone Provisioned:1件(gpt-5.2) |
| 日本の地理区分内 | Standard:5件(gpt-4.1-mini、gpt-4o、埋め込み3種) | Regional Provisioned:15件(gpt-5.4、gpt-5.4-mini、gpt-5.2、o4-miniなど) |
東日本で提供されるAzure OpenAIのモデルとバージョンの組み合わせの数。処理範囲は[3]、提供状況は[4](2026年9月3日更新)による。
国内処理のまま従量課金を使うと、チャットモデルはgpt-4.1-miniとgpt-4oに限られる。gpt-5系を国内処理で使う手段はRegional Provisionedだけで、対象はgpt-5・gpt-5-mini・gpt-5.1・gpt-5.2・gpt-5.4・gpt-5.4-miniの6件だ[4]。従量課金は共有リソースプールの上で動くので、一時的な調整を避けたい本番ワークロードの行き先は[1]が案内するPTUになり、国内処理が要件ならそれは東日本のRegional Provisionedになる。西日本は、Azure OpenAIのモデルについてはどのデプロイタイプの表にも掲載がない[4]。
まとめ
429は4つの類型に分かれ、クォータの操作で対処するのはレート制限の超過だけだ。クォータのプールがサブスクリプション単位に広がっても、レート制限はデプロイメントごとにかかり、一時的な調整は顧客をまたぐ共有リソースプールの側で起きる。手を入れる順番は次のとおり。
- アプリのログに、429のエラーメッセージ本文と
x-ratelimit-limit-tokens・retry-after-msの値を残す。件数だけでは類型を判別できない - 429が出たデプロイメントの割当TPMを、サブスクリプションの残量ではなくデプロイメント単位で確かめる
- max_tokensを想定する応答長まで下げ、RPMの小さいモデルでは送信を平準化する
- 承認済みクォータの範囲内で本番の429が続くなら、増枠申請ではなくサポートリクエストで調査を依頼する[1]
- 遅延に厳しい本番ワークロードで429が頻発するならPTUと比べる[1]。国内処理が要件なら、東日本のRegional Provisionedに使いたいモデルがあるかを先に確認する[4]
よくある質問(FAQ)
Q1. 429が出たらまず何を確認すればよいか。
エラーメッセージと、レスポンスヘッダのx-ratelimit-limit-tokensだ。ヘッダの値が設定TPMより低ければ、一時的なレート制限調整が起きている[1]。
Q2. クォータの増枠を申請すれば429は解消するか。
効くのはレート制限の超過による429だけだ。容量の逼迫と一時的な調整には再試行とPTUの検討、max_tokensが原因ならその見直しで対処する[1]。
Q3. サブスクリプション単位のクォータ管理は、すでに全モデルに適用されているか。
2026年5月7日以降、Realtime TranslateとRealtime Whisperから順次広げている段階で、全モデルへの適用はこれからとされている[2]。
出典
[1] Manage Azure OpenAI in Microsoft Foundry Models quota(Microsoft Learn)[2] Azure OpenAI in Microsoft Foundry Models quotas and limits(Microsoft Learn)
[3] Deployment types for Microsoft Foundry Models(Microsoft Learn)
[4] Region availability for Foundry Models sold by Azure(Microsoft Learn)
[5] List of Azure regions(Microsoft Learn)