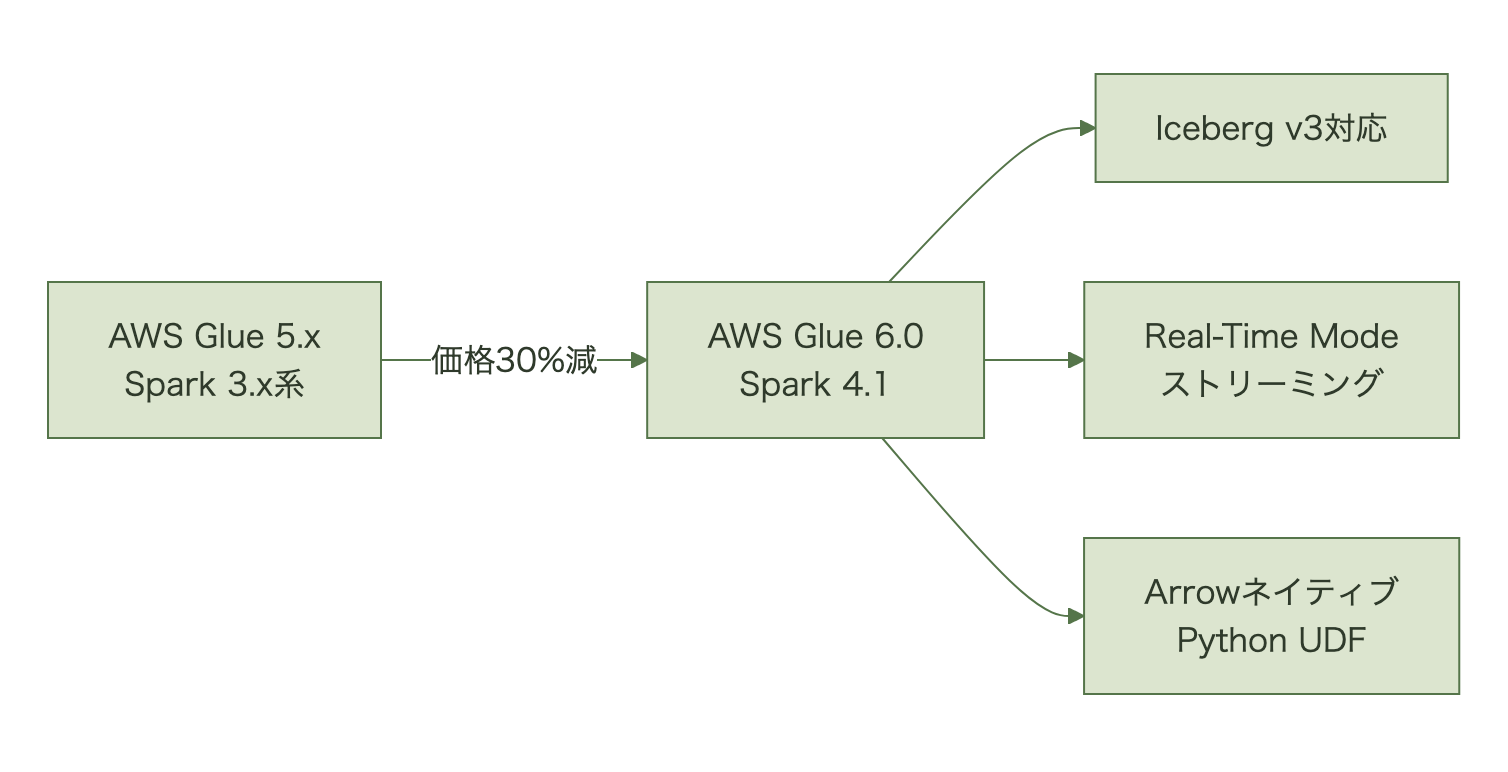
AWSは2026年8月21日、AWS Glue 6.0の一般提供を始めた[1]。Glue 6.0で動かすジョブは、Glue 5.1比でDPU時間あたりの料金が30%下がる[2]。実行基盤はApache Spark 4.1・Python 3.13・Scala 2.13に更新され、テーブルフォーマットのApache Iceberg v3にも対応した[1]。
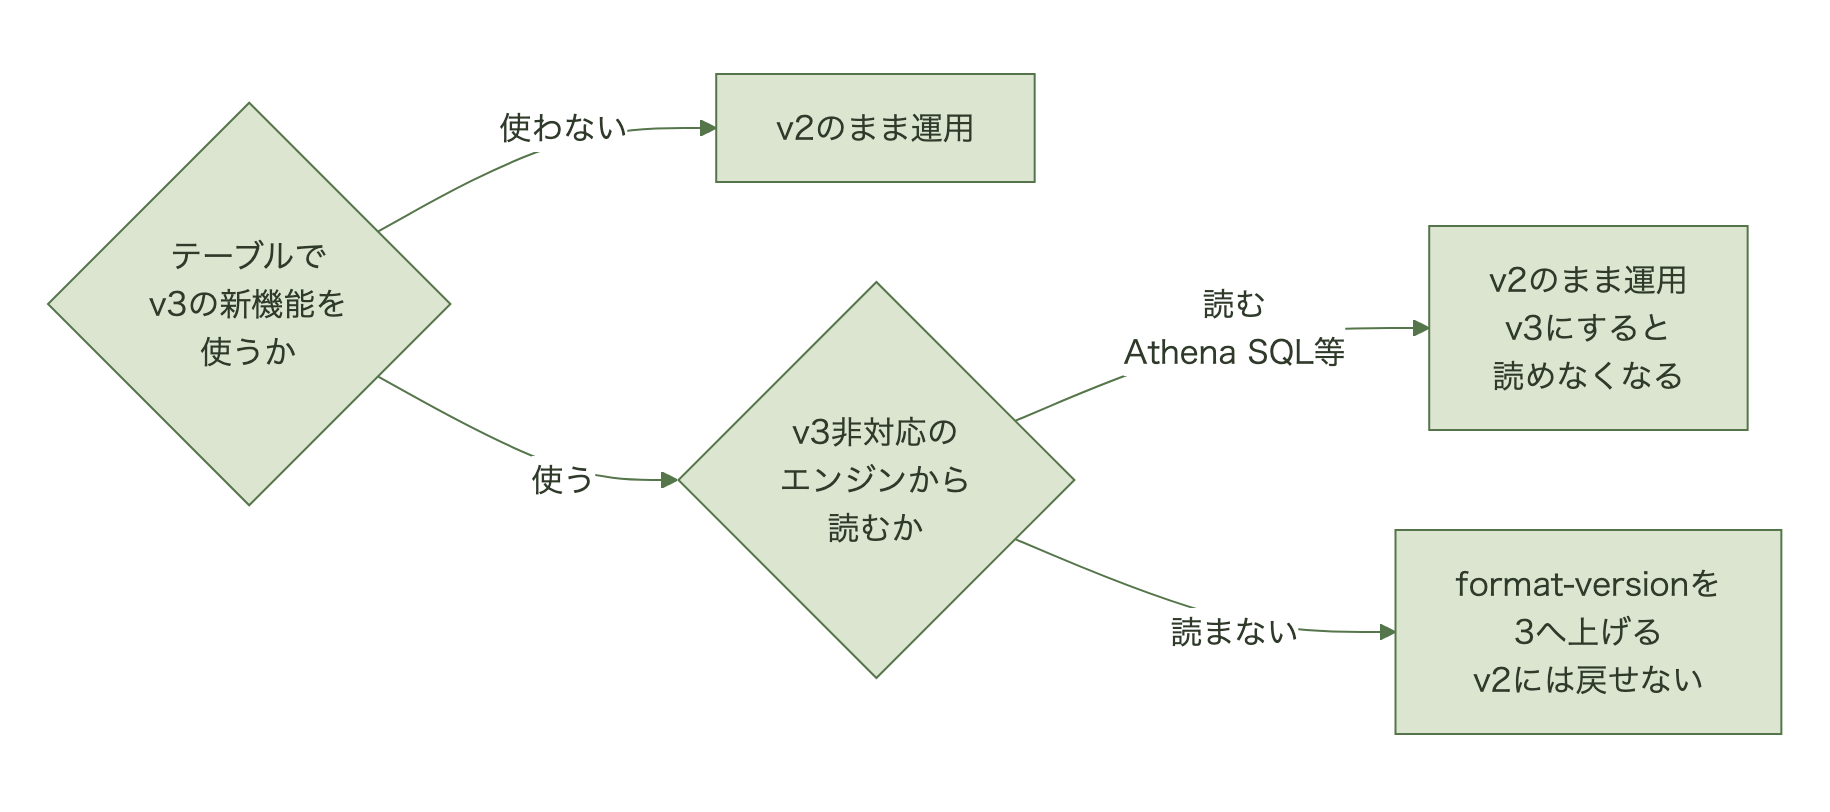
値下げは、ジョブのGlueバージョンを6.0に切り替えた時点で効く。一方でSpark 4.1への更新には既存コードが動かなくなる変更が含まれ、Iceberg v3への移行はテーブル単位の一方向の変更で、上げたテーブルはAthena SQLから読めなくなる[3]。同じリリースに、判断の単位が違う3つの変化が入っている。
予備知識
- AWS Glue: AWSが提供するサーバーレスのETL(データ抽出・変換・格納)サービス。Apache Sparkを実行基盤に使う。
- DPU(Data Processing Unit): Glueの処理能力と課金の単位。1 DPUは4 vCPU・16GBメモリで、料金は使ったDPU数と実行時間(秒単位)で決まる[4]。
- Apache Iceberg: 巨大なテーブルを複数の処理エンジンから安全に読み書きできるようにする、オープンなテーブルフォーマット。仕様のバージョン(format-version)はv3まで確定している[5]。
- 削除ベクター(Deletion Vector): 削除した行の位置を、データファイルごとのビットマップで記録する仕組み。Iceberg v3で加わった[5]。
- VARIANT型: JSON等の半構造化データを、スキーマを固定せずに格納できるデータ型。
Iceberg v3で追加された機能を理解する前提として、テーブルフォーマットの基本構造を押さえられる。


AWS Glue 6.0で何が変わったのか
AWSのBig Data Blogによると、Glue 6.0で動くジョブはGlue 5.1比でDPU時間あたり30%安くなり、ジョブ設定の変更は要らない[2]。料金ページでは、Glue 2.0〜5.1のSparkジョブが同じ単価で、6.0以降だけが安い単価になっている[4]。5.1より前のバージョンから移る場合も、単価の下げ幅は同じ30%である。AWSが3TB規模のTPC-DSベンチマーク(G.2Xワーカー30台、S3上のParquet)で試算したコストは、Glue 5.1の8.87ドルに対し6.0は5.61ドルだった[2]。単価の差に実行時間の短縮が重なった結果で、AWS自身が測った値である。
実行基盤の更新に伴い、Spark宣言的パイプライン(Spark Declarative Pipelines)によるオーケストレーションコードの削減、サブ秒レイテンシーのリアルタイムモードストリーミング、PySparkの処理を高速化するArrowネイティブのPython UDFも使えるようになった[1]。
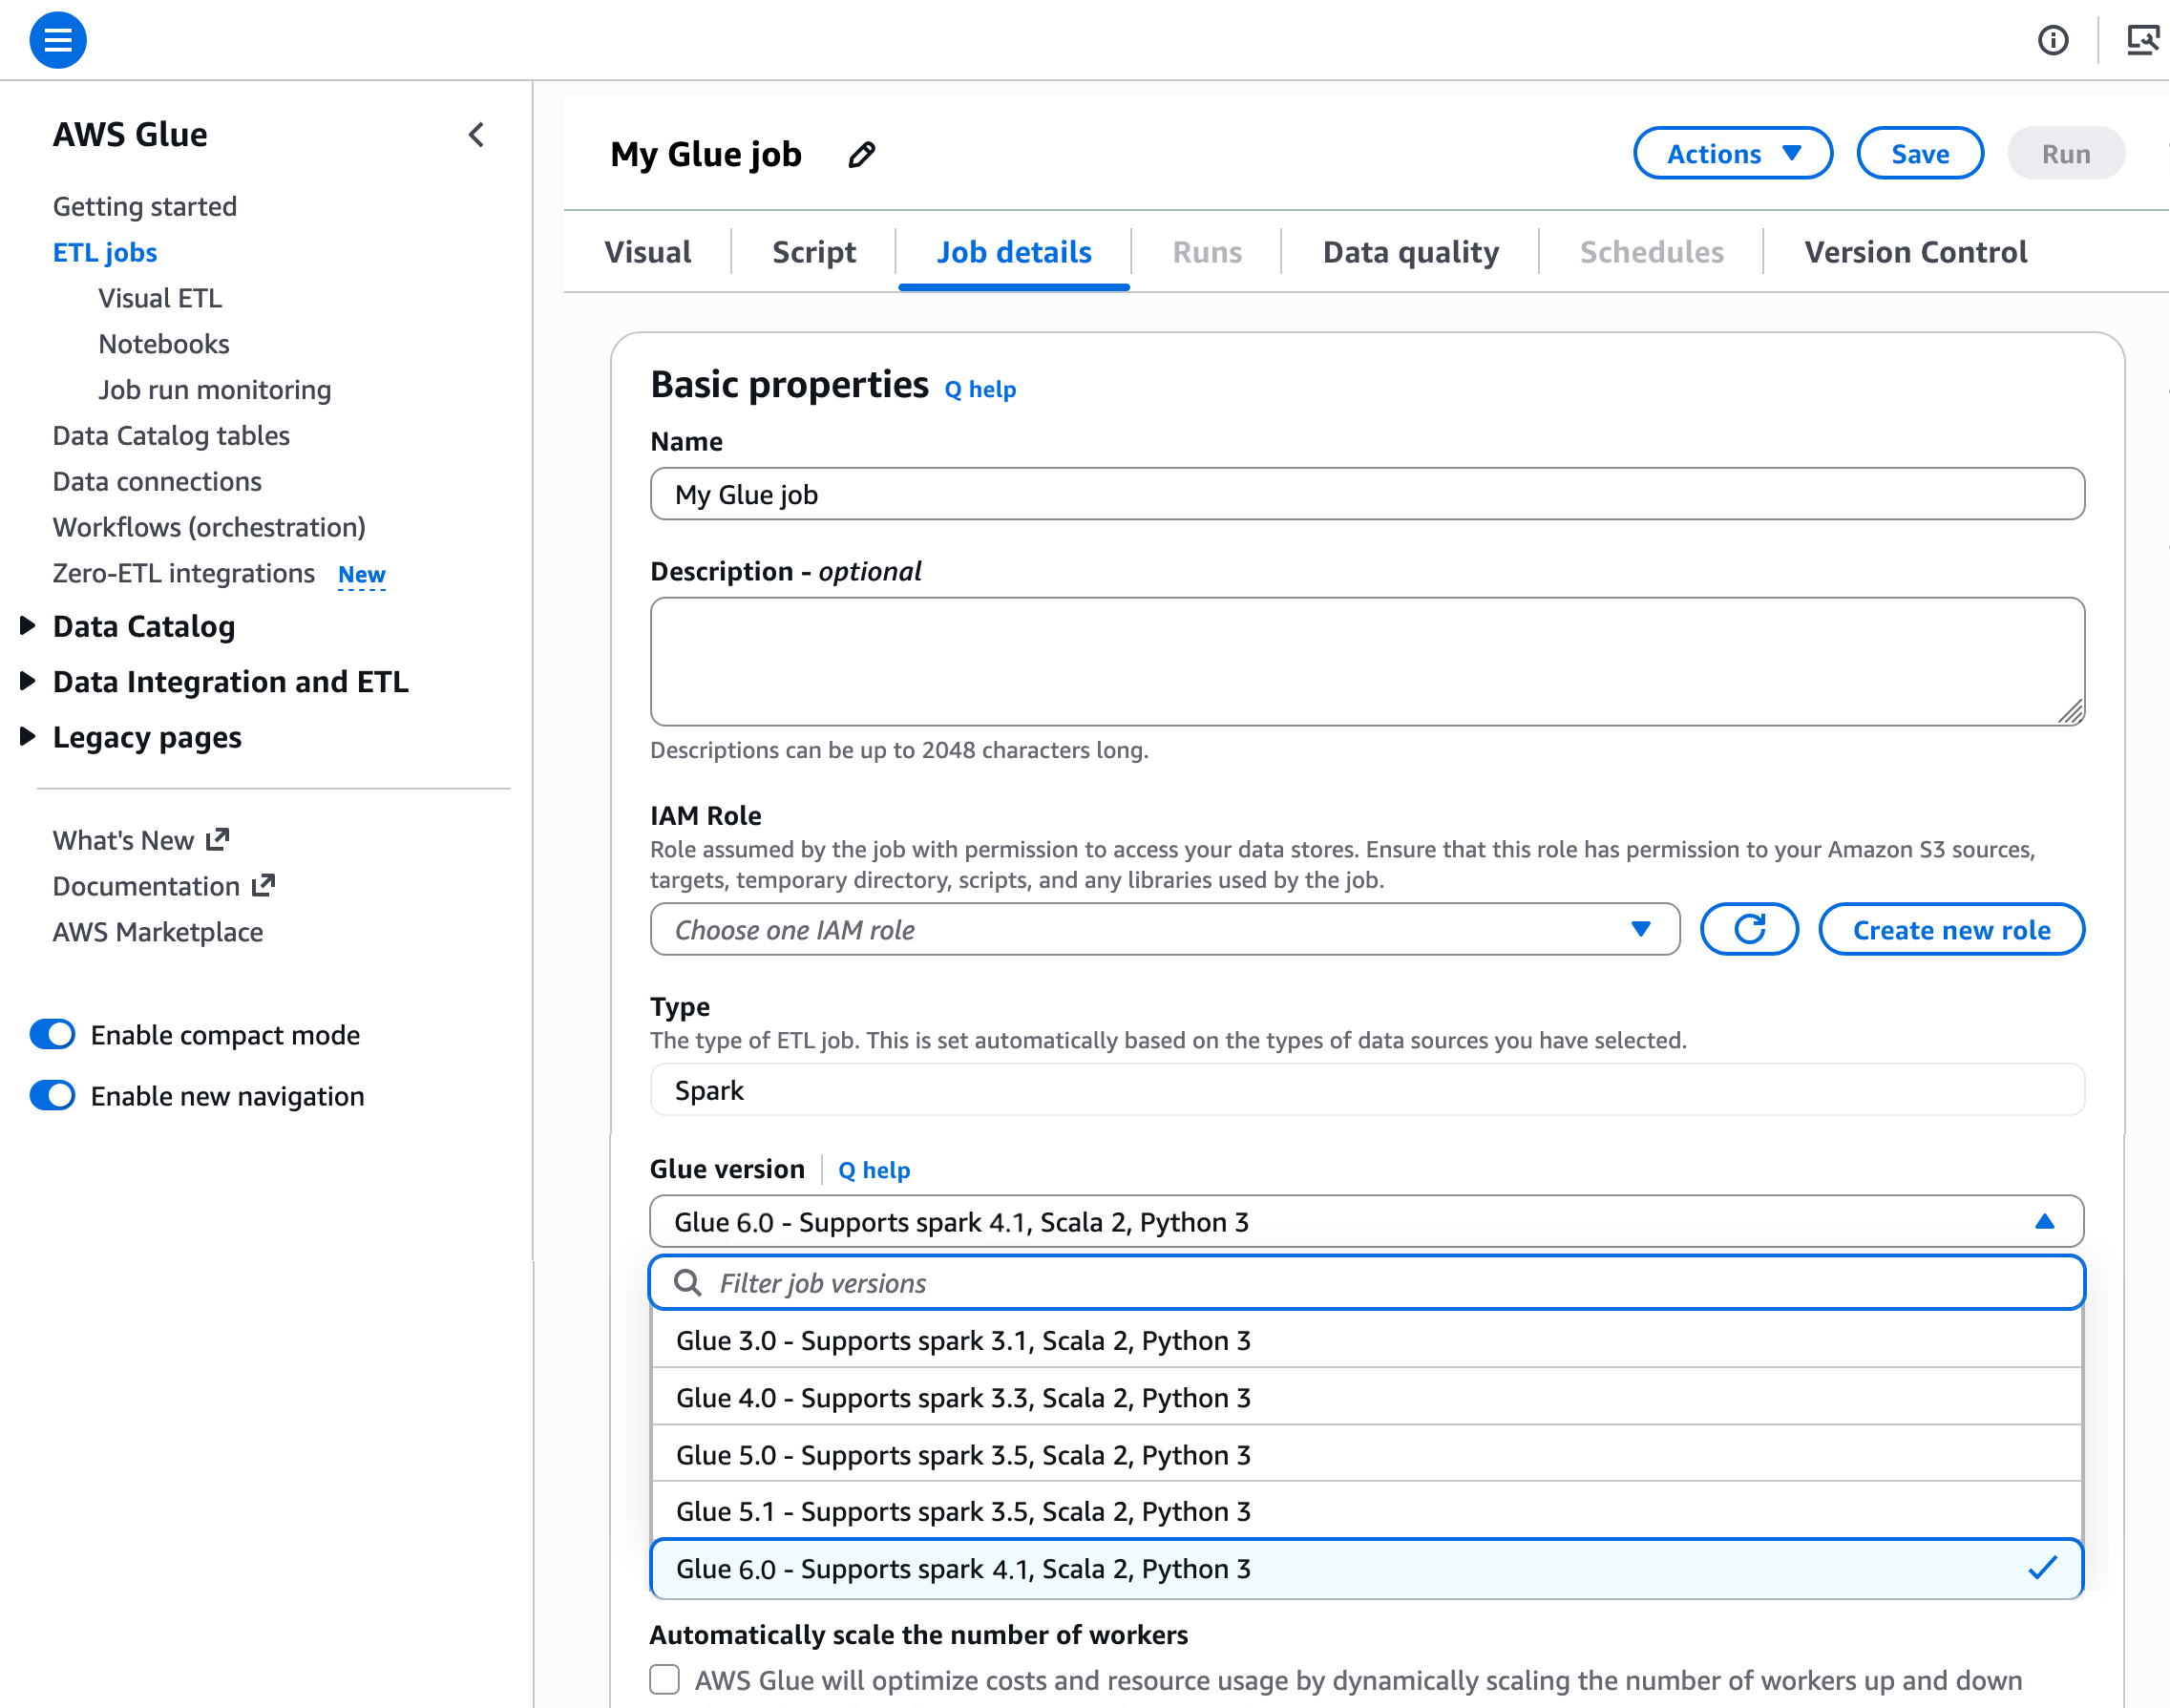
新規ジョブはコンソールのGlue versionで6.0を選べばよく、APIの変更は要らない[6]。既存ジョブの移行には、生成AIを使ったアップグレードエージェント(Generative AI Upgrade Agent for Apache Spark)を使える[1]。対象はGlue 2.0以降のジョブである[3]。
AWS GlueをS3・Athena・Lake Formationと組み合わせたデータレイク構築の全体像を、日本語で体系的に学べる。

Apache Iceberg v3対応で何が使えるようになるか
Glue 6.0はIceberg 1.11.0を搭載し、v3仕様の機能に対応した[2]。発表で挙げられた主な機能は次のとおり[1][6]。
| Iceberg v3の機能 | 何が変わるか |
|---|---|
| 削除ベクター | v2の位置削除ファイルに代わり、データファイルごとのビットマップで削除行を記録する |
| VARIANT型 | JSON等の半構造化データをスキーマ固定なしで格納できる。Glueは中身を列単位に自動で分解し、読み取りを速める |
| geometry / geography型 | 位置情報などの空間データをテーブル内で扱える |
| ナノ秒精度のタイムスタンプ | v2までのマイクロ秒より細かい、ナノ秒単位の時刻を記録できる[5] |
| UNKNOWN型・DEFAULT列値 | 型が未定の列を置ける。列を追加したとき、既存行を書き直さずに既定値を当てられる |
これらの機能は、既存のIcebergテーブル(v2形式)のままでは使えない。テーブルのformat-versionを3に上げる必要があり、Glue 6.0への移行とは別の判断になる。
削除ベクターは、データファイルの書き直しをなくす機能ではない。v2でも、行の削除や置き換えはデータファイルを書き直さずにできる[5]。v2は削除した行を位置削除ファイルに記録し、v3はそれを、データファイルごとのビットマップ(削除ベクター)に置き換える。v3のテーブルには新しい位置削除ファイルを追加できず、1つのデータファイルに対する削除ベクターはスナップショット内で1つに限られる[5]。読み取り時は複数の削除ファイルを読む代わりに、圧縮されたビットマップを読めばよくなる[2]。AWSが更新の多いCDC(変更データキャプチャ)のテーブルで比べた例では、v3テーブルの読み取りはv2の1.5倍以上速かった[2]。
What’s Newの発表文は削除ベクターを6.0の機能に並べているが[1]、AWSの移行ガイドによると、削除ベクター自体はGlue 5.1のETLですでに使えた。移行ガイドが6.0の新機能として挙げるのは、VARIANT型・ナノ秒精度のタイムスタンプ・空間データ型である[3]。
v3への変更は一方向で、上げたテーブルはv2に戻せない[3]。Icebergの仕様は、実装が自分の対応するより新しいformat-versionのテーブルを読むと例外を投げるよう定めており[5]、v3に上げたテーブルはv3非対応のエンジンから読めなくなる。AWSの移行ガイドも、format-versionを3にしたテーブルはAthena SQLから読めない(エラーはCannot read unsupported version 3)とし、Athenaと共有するテーブルはv2のままにするよう勧めている。v3の新しいデータ型はSpark DataFrameでしか使えず、DynamicFrameとGlue StudioのVisual ETLは対応していない。VARIANT列には細かいアクセス制御(FGAC)もかけられない[3]。
SnowflakeとBigQueryを事業部ごとに使い分け、両者をまたぐデータ統合基盤の刷新を検討している数千人規模企業のデータ基盤担当者は、部門横断の分析を行うたびにETL(Extract-Transform-Load、データを抽出・変[…]
移行を判断する上での注意点
Glue 5.1のSpark 3.5.6から6.0のSpark 4.1.1への更新は、メジャーバージョンの更新にあたる。AWSの移行ガイドは、既存ジョブが動かなくなる変更として次を挙げている[3]。
| 変更点 | 影響を受けるジョブ | 対応 |
|---|---|---|
| ANSIモードが既定で有効 | 整数のオーバーフロー・不正なキャスト・配列の範囲外参照を含むSQL処理 | NULLを返していた箇所が例外になる。spark.sql.ansi.enabled=falseで旧挙動に戻せる |
| Scala 2.12→2.13 | Scala 2.12でビルドした独自JARを使うジョブ | Scala 2.13.17で再ビルドする |
| AWS SDK for Java v1の削除 | com.amazonaws.*を使うScala/Javaジョブ | SDK v2へ書き換える。Pythonのboto3はそのまま使える |
| EMRFSの削除 | EMRFS固有の設定を持つジョブ | 設定を外す。S3へのアクセスはS3Aに一本化される |
| Python 3.11→3.13 | 3.12・3.13で削除されたモジュール(imp・cgiなど)を使うPySparkジョブ | それらのモジュールを使わない書き方に直す |
| SQLContextの削除 | SQLContextを使うコード | SparkSessionを直接使う |
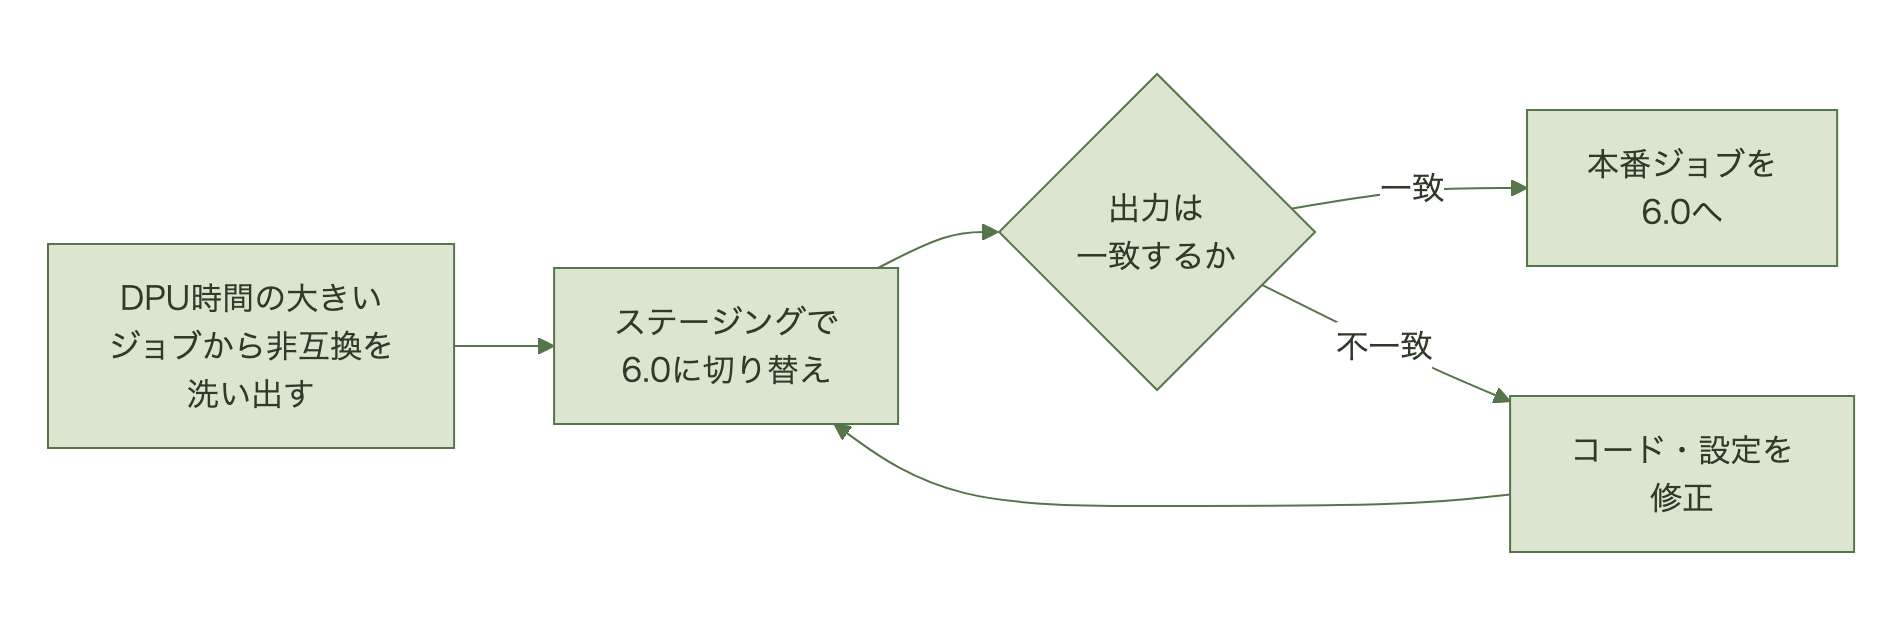
PySparkで書かれ、–extra-jarsで外部JARを読み込まず、AWSの呼び出しをboto3で行っているジョブは、Scala・SDKの項目には当たらない。独自のScala/Java JARを持つジョブほど作業が増える。日付・時刻のパースの既定(spark.sql.legacy.timeParserPolicy)も変わっており、パース結果が変わる場合がある[3]。例外で止まる変更はテスト実行で見つかるが、パース結果の違いは出力を突き合わせないと見つけにくい。ステージングで旧バージョンと6.0の出力を突合する検証が要るのはこのためである。
単価の下げ幅はどのジョブでも30%だが、削減額はDPU時間に比例する。移行はDPU時間の大きいジョブ、つまり請求額の大きいジョブから進めると、効果が早く請求に表れる。
数百人規模の情報システム部門でSnowflake(クラウド型データウェアハウスサービス)の運用とコスト管理を担うFinOps担当者にとって、月次のクレジット消費予算が読めなくなる変更が今年すでに恒久適用されている。Snowflakeは動作[…]
東京・大阪リージョンでの提供と料金
Glue 6.0は、すべての商用リージョンとAWS GovCloud(US)、AWS中国リージョンで提供されている[1]。Glueのエンドポイント一覧には東京(ap-northeast-1)と大阪(ap-northeast-3)が含まれ[7]、国内の2リージョンでも6.0を選べる。単価も両リージョンで同じである[4]。
| 項目 | 東京(ap-northeast-1) | 大阪(ap-northeast-3) |
|---|---|---|
| Glue 6.0の提供 | あり | あり |
| Sparkジョブ単価(Glue 2.0〜5.1) | 0.44ドル/DPU時間 | 0.44ドル/DPU時間 |
| Sparkジョブ単価(Glue 6.0以降) | 0.308ドル/DPU時間 | 0.308ドル/DPU時間 |
単価は2026年9月時点のAWS Glue料金ページの表示で、米国東部(バージニア北部)とも同額である。柔軟な実行(Flex)の単価も、0.29ドルから0.203ドルへ同じ比率で下がっている[4]。東京と大阪にジョブを分けて置く構成でも、6.0にそろえた後の単価はリージョンで変わらない。
まとめ
Glue 6.0の値下げは、ジョブのバージョンを切り替えれば効く。Spark 4.1への更新とIceberg v3への移行は、それぞれ別の検証と判断を伴う。
最初に手を付ける作業は2つある。1つは、Athenaなどほかのエンジンからも読んでいるIcebergテーブルを洗い出し、v3に上げない対象として決めておくこと。もう1つは、DPU時間の大きいジョブから移行ガイドのチェックリスト(Scala 2.13での再ビルド、SDK v1の除去、ANSIモードの影響)を当て、ステージングで出力を突き合わせてから本番を6.0に切り替えることである。
よくある質問(FAQ)
Q. AWS Glue 6.0への移行は必須ですか。
A. 必須ではない。コンソールでは3.0〜5.1も引き続き選べる[6]。ただし30%安い単価が適用されるのは6.0以降のジョブだけである[4]。
Q. Iceberg v3の新機能を使うには、テーブルを作り直す必要がありますか。
A. 作り直しは要らず、テーブルのformat-versionを3に上げる。v2時代の位置削除ファイルは、上げた後も有効なまま扱われる[5]。ただし上げたテーブルはv2に戻せず、Athena SQLからは読めなくなる[3]。
Q. Spark 4.1への更新で、既存のジョブが動かなくなることはありますか。
A. ある。AWSの移行ガイドは、Scala 2.12でビルドしたJAR、AWS SDK for Java v1を使うコード、EMRFS固有の設定を非互換として挙げている。ANSIモードが既定で有効になり、これまでNULLを返していたオーバーフローや不正なキャストは例外になる[3]。
Q. 東京・大阪リージョンでGlue 6.0は使えますか。
A. 使える。Glue 6.0はすべての商用リージョンで提供されており[1]、東京・大阪ともにSparkジョブの単価は1 DPU時間あたり0.308ドルである[4]。