数百のマイクロサービスから日々テラバイト級のログをCloudWatch Logsへ流し込んでいる企業のSRE・運用担当にとって、ログの保存コストは放置しがちな固定費だ。多くの現場では、監査要件や障害調査への備えから「念のため全部Standardクラスで長期保存」という設定のまま運用が続いている。
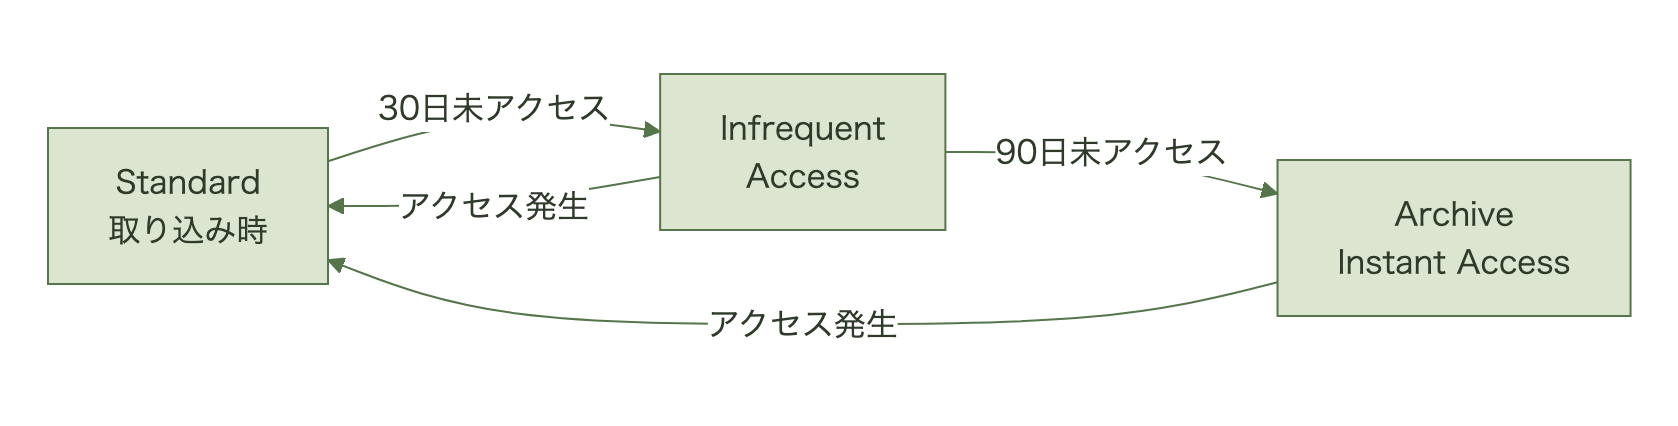
AWSは2026年7月15日、CloudWatch Logsに「インテリジェント階層化」を追加した[1]。アクセス頻度に応じて、Standard→Infrequent Access(30日以上未アクセス)→Archive Instant Access(90日以上未アクセス)へ自動的にデータを移す仕組みで、リージョン単位・アカウントレベルで有効化する[3]。あわせて、Infrequent Accessログクラスは2026年3月にOpenSearch SQL・PPLクエリでの分析と、機密情報を自動検知・マスキングするデータ保護機能に対応した[2]。
まず押さえておきたいのは、名前の似た2つの仕組みが別物である点だ。ログクラス(Standard/Infrequent Access)はロググループ作成時に選び、後から変更できない。階層(Standard/Infrequent Access/Archive Instant Access)はインテリジェント階層化が自動で動かす保存先である[3][4]。本稿ではこの2つを区別して扱う。
本稿では、インテリジェント階層化が何を変えるのか、既存のログ保存設計をどう見直すべきか、そして日本企業の監査・保存要件とどう両立させるかを整理する。
予備知識
- CloudWatch Logs: AWSのログ収集・保存・分析サービス。アプリケーションやインフラのログを一元的に集約する。
- Infrequent Access(IA)ログクラス: 取り込み単価がStandardより安いログクラス。ロググループ作成時に選び、後から変更できない。保存単価とLogs Insightsの課金はStandardと同じで、差が出るのは取り込み時だけ[4]。
- Archive Instant Access: インテリジェント階層化で最も保存単価が低い階層。90日以上アクセスのないログが対象で、クエリのレイテンシは他階層と同じ[3]。
- Logs Insights: CloudWatch Logsに対してクエリを実行し、ログを分析するための機能。
ログ・メトリクスの監視設計をCloudWatch中心に体系立てて学び直したい担当者向け。


現状分析:階層化前のコスト構造
これまでCloudWatch Logsは、Standardクラスと、より低コストなInfrequent Accessクラスを利用者が最初から選んで使い分ける方式だった。障害調査や監査でどのログがいつ必要になるか事前に判断しづらいため、多くの現場は安全側に倒してStandardクラスのまま長期保存する運用に落ち着いていた。この結果、実際にはほとんど参照されないログにも、Standardクラスの保存コストを払い続ける構造が生まれていた。
インテリジェント階層化は、この「最初にクラスを選ぶ」という前提そのものを変える。ログはまずStandard階層に置かれ、30日間アクセスがなければInfrequent Access階層へ、さらに90日間アクセスがなければArchive Instant Access階層へ、利用者の操作なしに移る[3]。有効化そのものにも階層間の遷移にも追加課金はなく、支払うのは各階層に置かれているデータの保存料だけだ[3]。
ログ階層化のような個別最適だけでなく、組織としてコスト最適化を継続する体制づくりを学べる一冊。

解決の方向性:機能ギャップの解消がもたらす選択肢の広がり
これまでInfrequent Accessログクラスへの移行をためらわせていた要因の一つが、機能面の制約だった。2026年3月の更新で、IAクラスは機微情報の自動検知・マスキングというデータ保護機能に対応した[2]。Logs Insightsクエリ言語・S3へのエクスポート・暗号化・OpenSearch SQL/PPLクエリは、StandardとIAのどちらでも利用できる[4]。
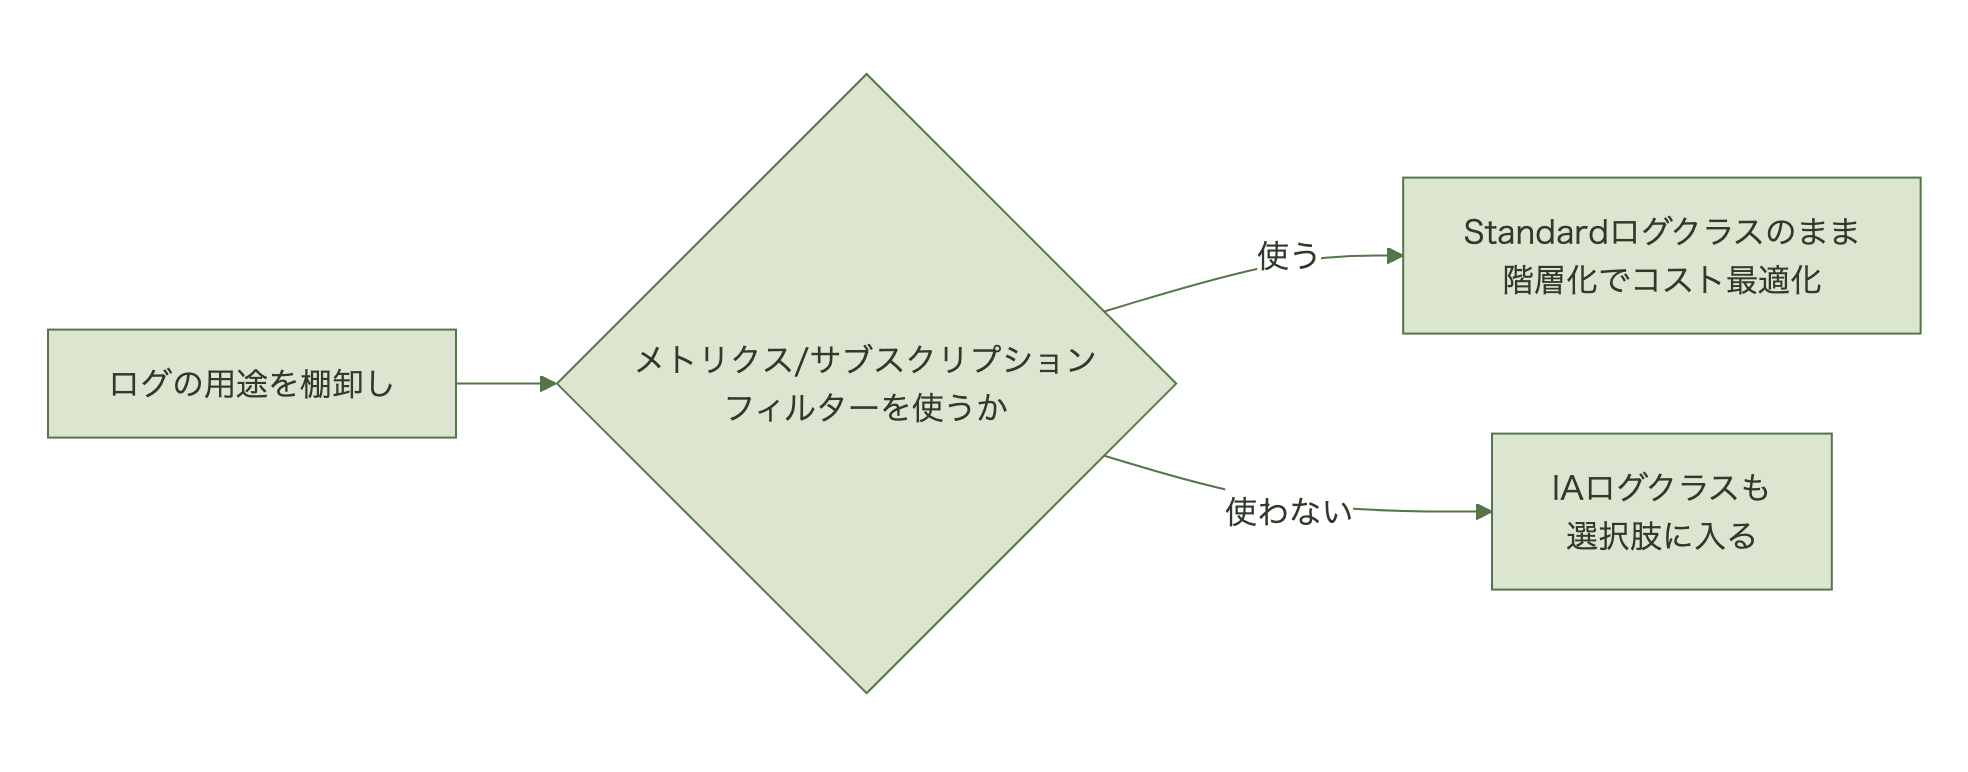
ただし機能差が消えたわけではない。Live Tail、サブスクリプションフィルター、メトリクスフィルター、GetLogEvents/FilterLogEvents、異常検出、フィールドインデックス、Embedded Metrics Formatは、いずれもIAクラスでは使えない[4]。運用系のロググループ——メトリクスフィルターでアラームを上げているもの、サブスクリプションフィルターで他サービスへ転送しているもの——は、取り込み単価が安くてもIAクラスへは移せない。IAが向くのは、事後の調査や監査で参照する「読むだけ」のログである。
| 項目 | Standard | Infrequent Access |
|---|---|---|
| 取り込み単価 | 標準 | Standardより安い[4] |
| 保存単価・Logs Insightsの課金 | 同じ[4] | 同じ[4] |
| Logs Insightsクエリ | 対応 | 対応(一部コマンドを除く)[4] |
| OpenSearch SQL/PPLクエリ | 対応[4] | 対応[4] |
| データ保護(機密情報マスキング) | 対応 | 2026年3月から対応[2][4] |
| S3エクスポート・暗号化 | 対応 | 対応[4] |
| メトリクスフィルター/サブスクリプションフィルター | 対応 | 非対応[4] |
| Live Tail/異常検出/フィールドインデックス/EMF | 対応 | 非対応[4] |
GetLogEvents/FilterLogEvents | 対応 | 非対応(Logs Insightsで参照する)[4] |
数百人規模で自社LLM基盤や生成AIサービスをAWS上に構築し、年次予算策定サイクルを持つ企業のインフラ担当・調達担当が対象になる。GPUインスタンスを一定期間確保できるCapacity Block(GPUインスタンスを予約購入できるAW[…]

具体施策:有効化前に確認すべきこと
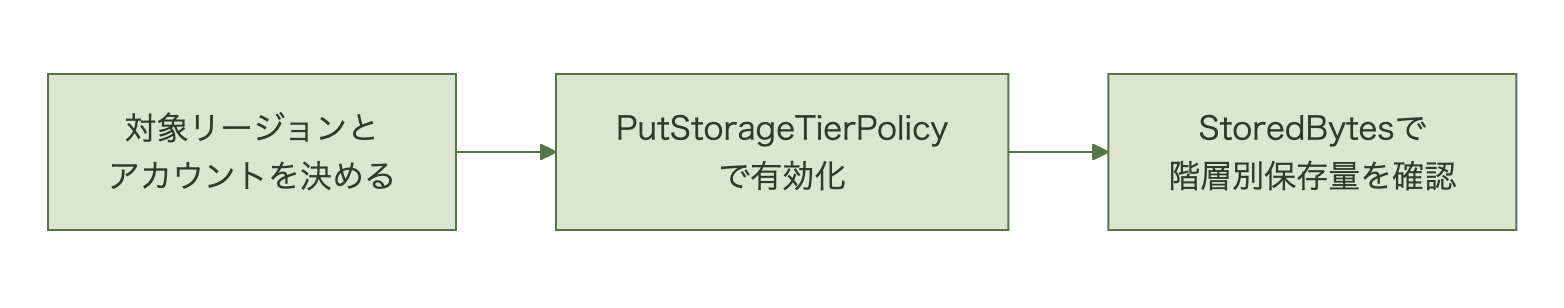
インテリジェント階層化は、リージョン内のアカウント単位で有効化する機能だ。CloudWatchコンソール、または PutStorageTierPolicy API(CLIなら aws logs put-storage-tier-policy --storage-tier INTELLIGENT_TIERING)で有効にすると、そのリージョンのアカウント内の全ロググループに適用される。ロググループ単位で対象外にする設定はなく、戻す場合も --storage-tier STANDARD でアカウントごと戻すことになる[3]。オール・オア・ナッシングである以上、有効化の判断はアカウント単位で行う必要がある。
階層ごとの保存量は AWS/Logs 名前空間の StoredBytes メトリクス(ディメンション LogGroupName・StorageType)で確認できる。ただしこの値は1日1回の更新で、階層遷移をリアルタイムには反映しない[3]。
また、対応リージョンは中東(バーレーン)・中東(アラブ首長国連邦)を除くすべての商用リージョンとなっている[3]。複数リージョンにログ基盤を分散させている企業は、リージョンごとに有効化状況を確認する作業が発生する。
数千人規模でAzure MonitorとDatadogを併用し、年次のコスト監査で監視ツール契約の妥当性を問われる企業のITインフラ担当者は、今回の発表を無視できない。対象はマイクロソフトのAzure Monitor、具体的にはSLI(サ[…]

監査での「即時参照性」要件と階層化の相性
日本企業の多くは、内部統制やセキュリティ監査の一環として、一定期間のログを「求められたら即座に提示できる状態」で保存することを社内規程で定めている。
技術的には、この点は問題にならない。AWSは Infrequent Access 階層について「Standard階層と同じクエリレイテンシとスループット」、Archive Instant Access 階層について「他の階層と同じミリ秒のクエリレイテンシ」を提供すると明記しており、「データがどの階層にあってもクエリ体験は変わらない」としている[3]。階層化によって参照が遅くなる、という懸念はドキュメント上は成立しない。
実務で問題になるのはむしろ規程の文言のほうだ。「Standardクラスで保持すること」のように保存先の名称で書かれている規程があると、実際の参照性能は変わらないのに、文言と運用が食い違う。監査部門に説明すべきは階層の名前ではなく、参照までの所要時間が変わらないという事実になる。
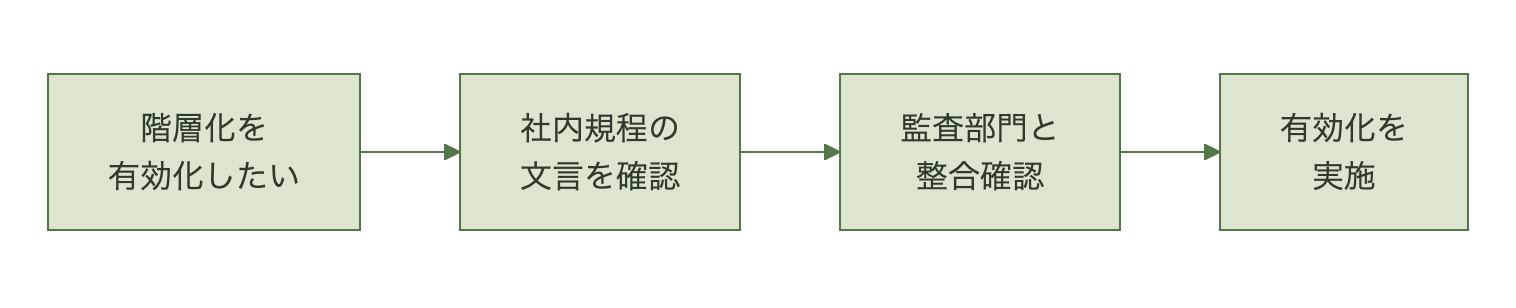
海外の組織では、コスト最適化の技術的な仕組みが先に導入され、社内規程やポリシー文書は実態に合わせて事後的に更新されることが多い。一方、日本企業では社内規程の変更自体が稟議・承認プロセスを要するため、技術的な機能を有効化する前に、規程側の文言が階層化後の運用と矛盾しないかを確認する順序になりやすい。
| 観点 | 海外の典型的な動き | 日本企業で起きやすいこと |
|---|---|---|
| 導入の順序 | まず有効化し、規程は事後に整合 | 規程との整合確認が先、有効化が後回しになりがち |
| 監査対応 | 階層化後も同じレイテンシで検索できることを技術的に説明 | 規程が保存先の名称で書かれていると、実態は変わらないのに文言の改定が要る |
| コスト削減の主体 | インフラチームが裁量で最適化 | 情シス部門が監査部門・経理と調整しながら進める |
IT部門担当者の次の一手は、ロググループ単位での保存要件の棚卸しと、社内規程の文言確認だ。決裁側の判断材料は、コスト削減効果と、規程改定にかかる調整コストを比較した上で、どの範囲から階層化を有効化するかという段階的な意思決定になる。
まとめ
CloudWatch Logsのインテリジェント階層化は、これまで一律Standardで保存してきたログのコスト構造を見直す機会になる。有効化も階層遷移も追加課金がなく、全階層でクエリのレイテンシが変わらない以上、技術的な導入障壁は低い[3]。一方でログクラスの選択(Standard/IA)は別問題で、メトリクスフィルターやサブスクリプションフィルターを使うロググループはIAへ移せない[4]。IT部門担当者の次の一手は、ロググループ単位の保存要件棚卸しだ。決裁側にとっての判断材料は、監査規程との整合を取りながら、どの範囲から段階的に階層化を有効化していくかという計画づくりになる。
よくある質問(FAQ)
Q. インテリジェント階層化を有効化すると、既存のログもすぐに移行されるか?
A. 有効化後、アクセスパターンに応じて自動的に階層が判定される[3]。既存ログも対象になるが、具体的な移行タイミングは各ログのアクセス履歴による。なお有効化にも階層遷移にも追加課金はない[3]。
Q. アーカイブ層に移行したログはすぐに検索できるか?
A. できる。AWSは全階層で同じクエリレイテンシを提供するとしており、Archive Instant Access階層も他の階層と同じミリ秒レベルで参照できる[3]。アクセスすると当該データはStandard階層へ戻り、そこから再び30日のカウントが始まる。
Q. ロググループごとに階層化の対象・非対象を分けられるか?
A. 分けられない。有効化するとリージョン内のアカウントの全ロググループに適用され、ロググループ単位で除外する設定は用意されていない[3]。対象を絞りたい場合は、アカウントやリージョンを分けるという設計側の対応になる。
出典
[1] https://aws.amazon.com/about-aws/whats-new/2026/07/amazon-cloudwatch-intelligent-tiering/[2] https://aws.amazon.com/about-aws/whats-new/2026/03/amazon-cloudwatch-infrequent-access-log-class
[3] https://docs.aws.amazon.com/AmazonCloudWatch/latest/logs/cwl_intelligent_tier.html
[4] https://docs.aws.amazon.com/AmazonCloudWatch/latest/logs/CloudWatch_Logs_Log_Classes.html