自社の大規模言語モデルをファインチューニングし、社内向けAIアシスタントを本番運用しているシステム子会社のインフラ担当者を想定する。GPUの調達方法として「1年前予約すれば安くなる」という単純な理解でAWS EC2 Capacity Blocks(一定期間のGPU容量を事前予約する仕組み)を契約していたが、2026年に入って予約価格そのものが2度値上げされ、当初のコスト試算が崩れた。
値上げそのものは既報のとおりで、本稿はその事実を繰り返すためのものではない。価格構造を確認したうえで、「予約は常に安い」という前提が崩れた2026年に、どの稼働率から予約が有利になるのかという分岐点を出すことを目的とする。
予備知識
- Capacity Block: AWSなどが提供する、特定期間のGPU容量を事前予約する仕組み。オンデマンドより安いことが前提とされてきたが、需給に応じて価格が変動する。
- オンデマンド: 予約なしで使った分だけ従量課金する利用形態。
- スポットインスタンス: 余剰キャパシティを大幅割引で利用できる代わりに、必要時に強制的に回収され得る利用形態。
- ネオクラウド: CoreWeave・Lambda・Nebiusなど、GPU特化型のクラウド事業者。ハイパースケーラーに比べ低価格を訴求することが多い。
GPU予約とオンデマンドの使い分けを、その場の判断ではなく社内のFinOps手順に落とし込みたい担当者向け。


GPU調達は4チャネル、価格差は8倍超
業界分析サイトIntuitionLabsが2026年に公表した分析によれば、GPU調達チャネルは大きく4種類に分かれる。ハイパースケーラー(AWS・Azure・Google Cloud・Oracle)、GPU特化型のネオクラウド(CoreWeave・Lambda・Nebius・Crusoeなど)、Vast.aiやRunpodのような長尾・マーケットプレイス型、そして自社でのハードウェア直接購入である。
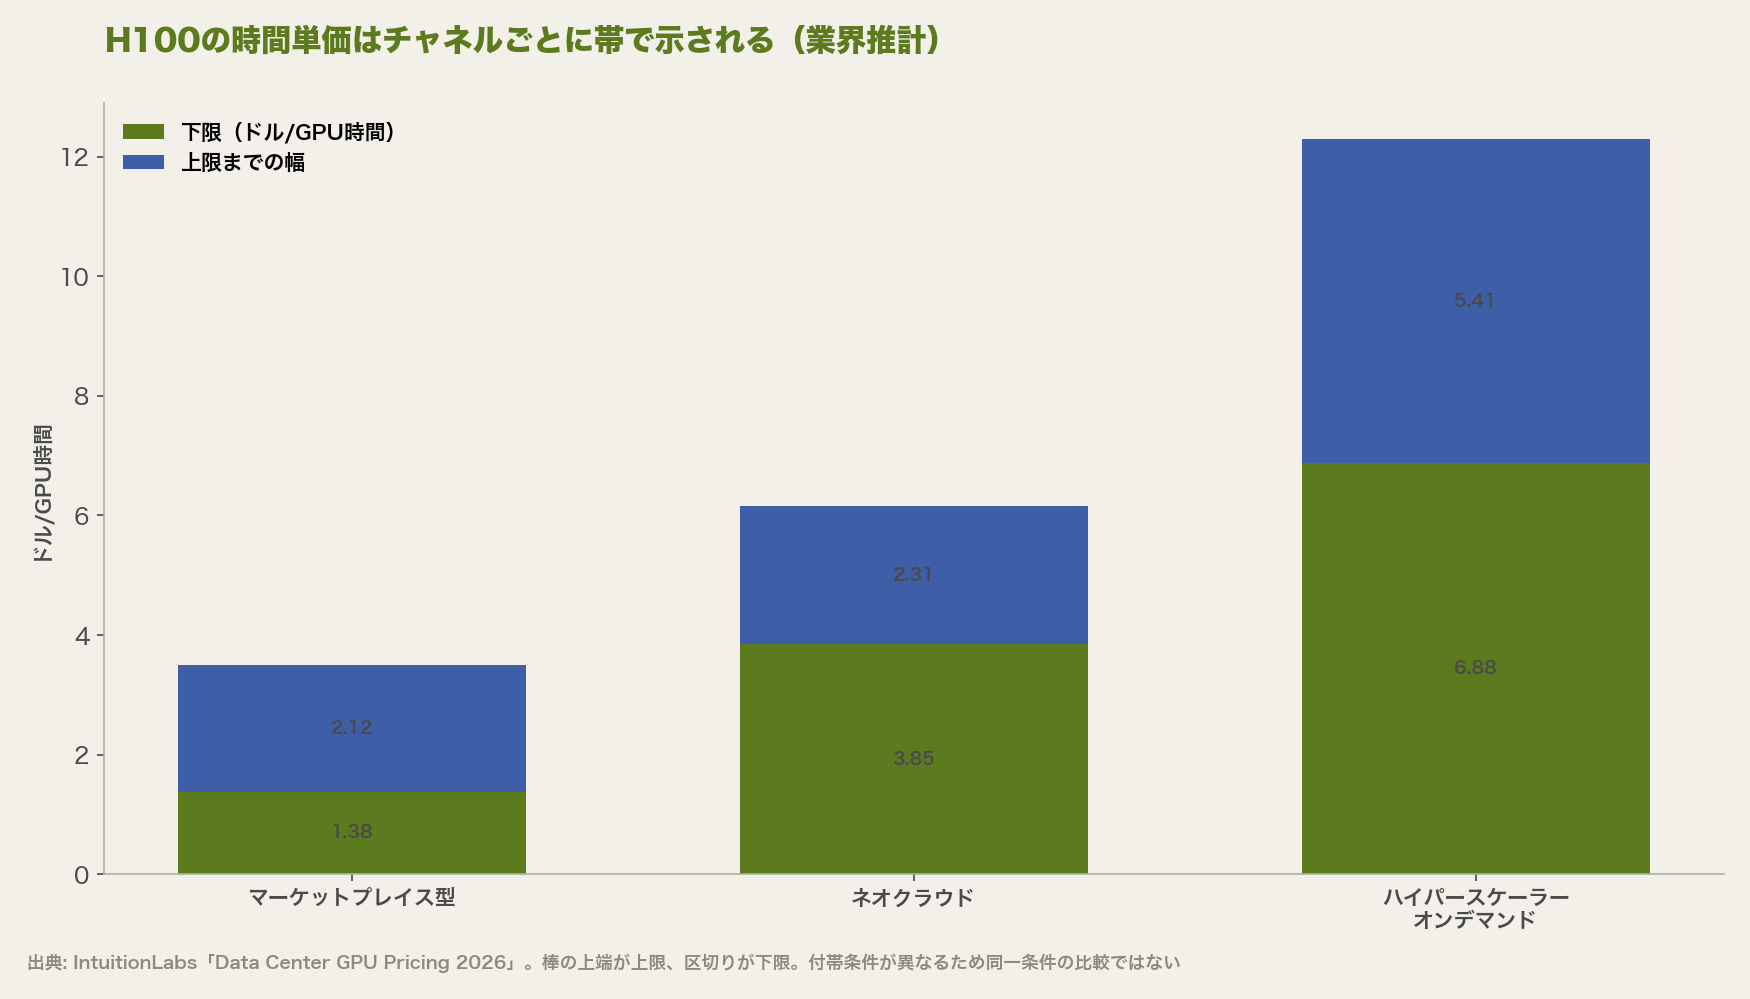
同分析はH100の時間単価について、28以上のプロバイダーを追跡する業界ダッシュボード(DeployBase)のデータを引用し、マーケットプレイス型が1時間1.38〜3.50ドル、ネオクラウドが3.85〜6.16ドル、ハイパースケーラーのオンデマンドが6.88〜12.29ドルという価格帯を示している[1]。ただし同分析自身が、これらは「同一条件の指数ではない」とし、中断され得るマーケットプレイス枠と予約枠とマネージドVMを同列に比較しないよう明記している。8倍前後という開きは、サービス範囲・可用性・付帯リソースの違いを含んだ数字である。ダッシュボード自体も本稿では確認していないため、業界推計として扱う。
予約とオンデマンドの配分を、時間単価ではなく会計上の固定費・変動費として捉え直したい担当者向け。

予約は本当に安いのか — 2026年に2度の値上げ
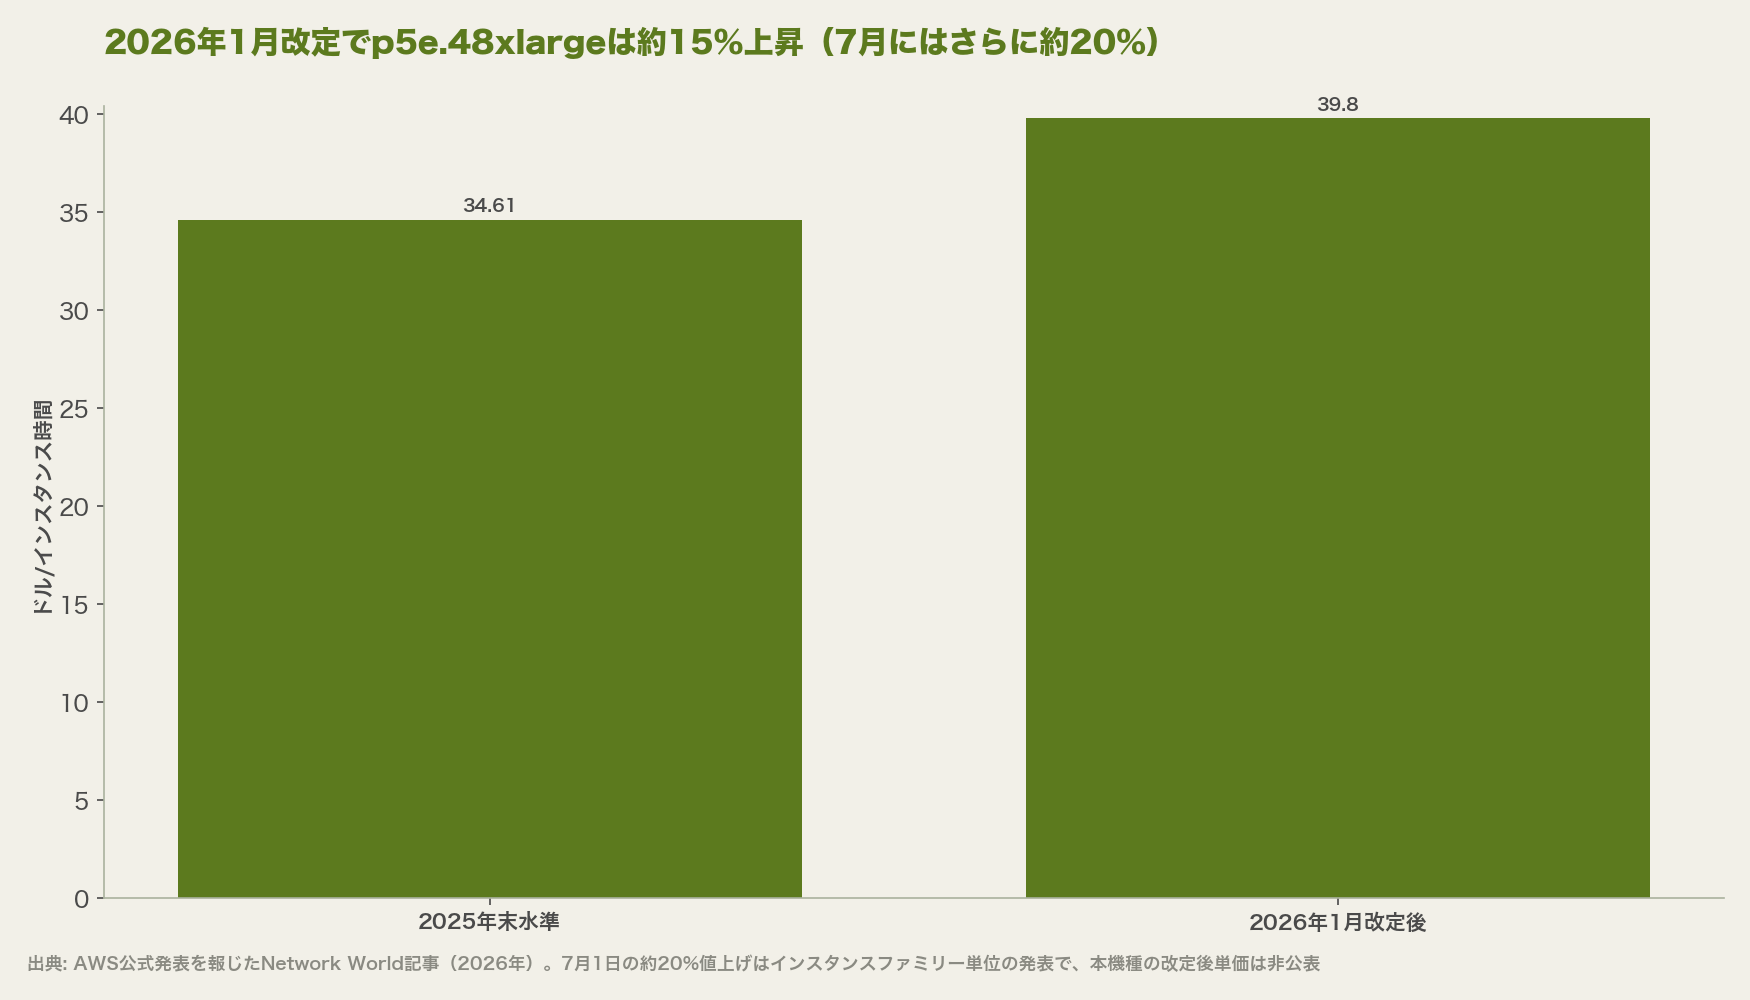
「予約すれば安い」という前提にも見直しが必要である。AWSはEC2 Capacity Blocksの価格を2026年に少なくとも2回引き上げた。1月にはp5e.48xlarge(H200×8)が1時間34.61ドルから39.80ドルへ約15%上昇し[3]、7月1日にはP6-B300・P6-B200・P5・P5e・P5en・P4deの各インスタンスファミリーで約20%の値上げが実施された[2]。7月の改定後、P6-B300は1アクセラレータあたり時間14.04ドル、P5(H100)は米国リージョンで1アクセラレータあたり時間5.191ドルという水準になっている[2]。最新の単価はAWSの公式価格ページで確認できる[6]。
AWSは「Capacity Blocksの価格は需給パターンに応じて変動する」と説明している[3]。2度の値上げが半年のうちに続いた点で、値下げを重ねてきたEC2の価格運用とは様相が異なる。
ただしこの説明には異論もある。クラウドコストアナリストのCorey Quinn氏は、これは価格ページに掲載された基準レートを書き換えたものであり「ポリシー判断であって需給ではない」と指摘している[2]。いずれの見方を取るにせよ、Capacity Blockが「固定価格の割引」ではなく、契約時点の価格が更新時にも維持される保証のない枠だという実務上の帰結は変わらない。
Amazon, $AMZN, AWS is reportedly raising prices on its EC2 Capacity Block reservations for machine-learning GPU instances by approximately 20% effective July 1, 2026, per Investing.com.
— unusual_whales (@unusual_whales) 元投稿を見る
この構造は、予算計画を年度単位で固定しがちな企業のIT部門にとって扱いにくい。従来のクラウドコスト最適化は、リザーブドインスタンスやSavings Plansのように「予約すれば単価が下がる」ことを織り込んで設計されてきた。GPU分野ではその足場が需給逼迫で動いている。年度予算を組む段階で、GPU調達費用に一定の変動幅(バッファー)を織り込む必要が出てきている。
数百人規模で自社LLM基盤や生成AIサービスをAWS上に構築し、年次予算策定サイクルを持つ企業のインフラ担当・調達担当が対象になる。GPUインスタンスを一定期間確保できるCapacity Block(GPUインスタンスを予約購入できるAW[…]

ハイブリッド調達という現実解
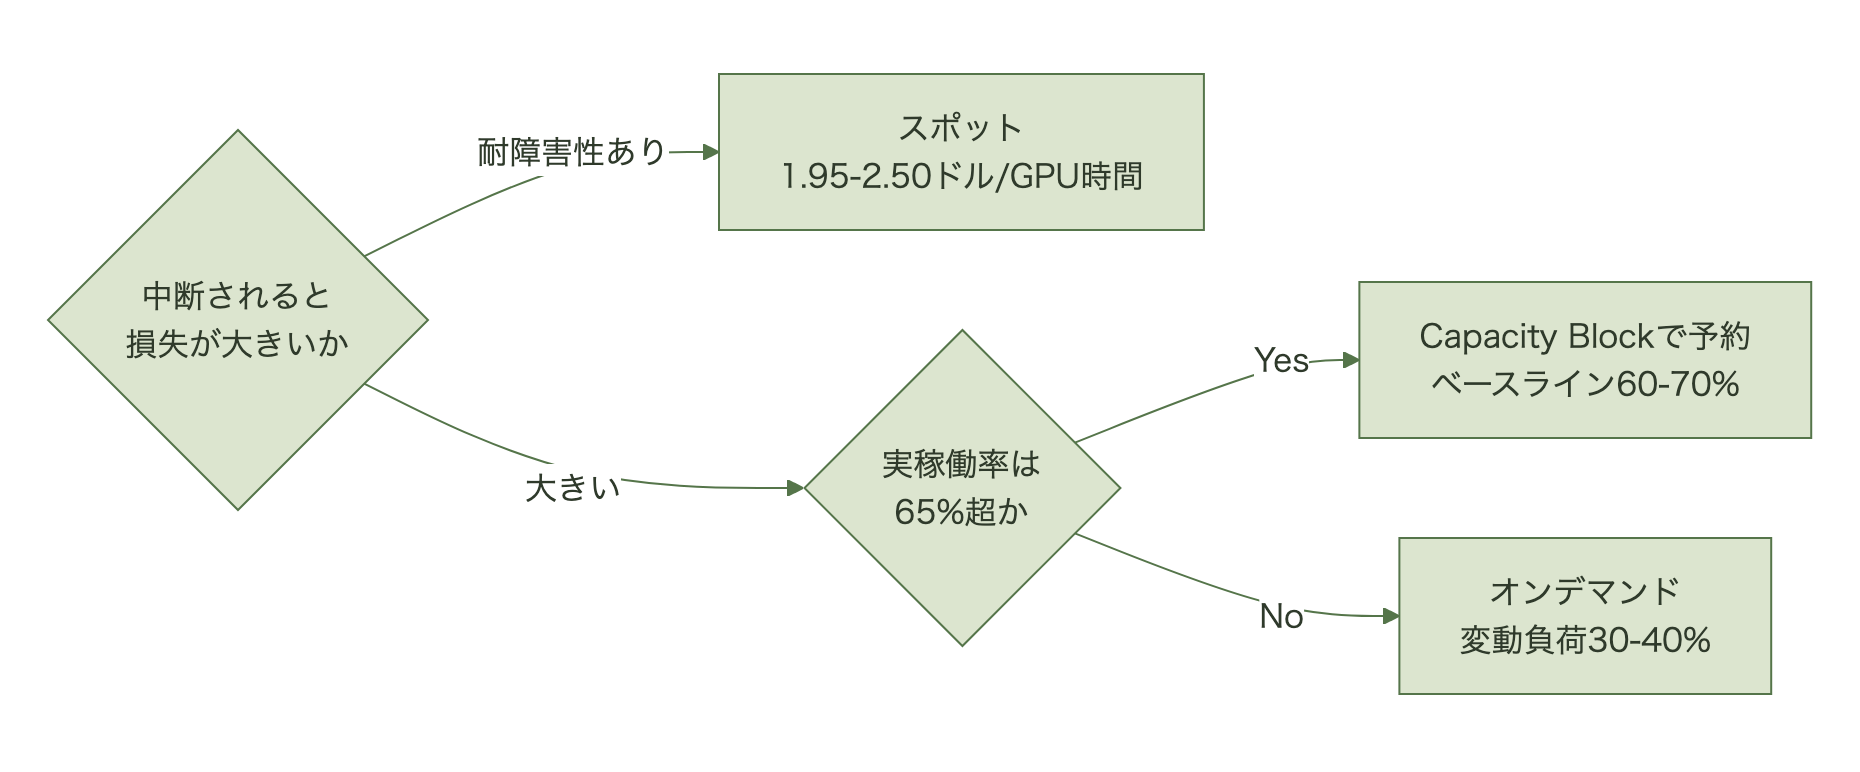
この状況を踏まえ、実務でのGPU調達は「予約か、オンデマンドか」の二択ではなく、ワークロードの性質に応じて組み合わせる設計に落ち着いている。FinOps支援を手掛ける事業者が示す目安としては、常時稼働するベースライン処理の60〜70%を予約でカバーし、残り30〜40%は変動負荷向けにオンデマンドまたはスポットで確保するという配分がある[2]。
チェックポイント(学習途中の状態保存)を確実に行える耐障害性の高いワークロードであれば、同じFinOps事業者の比較表ではスポットは1GPU時間あたり1.95〜2.50ドル程度とされ、オンデマンドよりさらに安く済む[2]。一方、納期の決まった学習ジョブのように処理途中で中断されるコストが大きい場合は、価格変動のリスクを承知のうえでCapacity Blockを使う判断が妥当になる。配分比の前に、どこから予約が有利になるのかを一度計算しておきたい。Capacity Blockは予約した時間ぶんを使わなくても課金されるのに対し、オンデマンドは動かした時間だけの課金になる。予約単価をR、同等スペックのオンデマンド単価をD、予約枠のうち実際に回す割合をUとすると、予約が有利になる条件は R÷U < D、つまり U > R÷D である。
H100で数字を入れてみる。AWSの公式価格ページによれば、p5.48xlargeのCapacity Block単価は米国リージョンで1インスタンス41.528ドル、1アクセラレータあたり5.191ドルである[6]。これに対しハイパースケーラーのオンデマンドは1GPU時間あたり6.88〜12.29ドルの帯にある[1]。分岐点は帯の下端に対して5.191÷12.29=約42%、上端に対して5.191÷6.88=約75%となる。実稼働が4割を切れば予約はどう転んでも損、8割を超えれば比較対象がどれでも得で、その間はオンデマンド側の実勢価格しだいという構図になる。60〜70%を予約に寄せるという配分の目安は、ちょうどこの不確定な帯の内側に収まっている。
重要なのは、予約を「常に得」と考えるのではなく、中断コストとプレミアムを天秤にかけてワークロードごとに使い分けることである。この配分比率は固定値ではなく、四半期ごとにワークロードの実績稼働率を見ながら見直す運用が要る。予約分を過大に確保すると値上げ後の固定費が膨らみ、過小だとオンデマンド・スポットの価格変動に振り回されるため、四半期ごとの棚卸しが欠かせない。
数千台規模のクラウドKubernetesクラスタでAI/ML基盤を運用し、GPU予算が前年から急増している情報システム部門のインフラ担当にとって、稼働率の実態は投資判断そのものを左右する数字になる。予算要求の起点になるのはGPU(画像処理[…]
日本企業は「予約契約の交渉力」より「国内ネオクラウド」が現実解
米国の分析は主にハイパースケーラーとの価格交渉力を持つ大企業を前提にしているが、日本企業の多くはAWSやAzureに対してCapacity Blockの価格変動リスクを個別に交渉できるほどの調達規模を持たない。この差が、日本市場で異なる選択肢を後押ししている。
さくらインターネットは経済産業省の支援を受け、生成AI向けGPU基盤に総額1,130億円規模の投資を計画し、新たに設置したB200 GPUを約1,100基、2026年2月に国内大手企業向けの提供を開始した[5]。ソフトバンクも2026年10月から「Infrinia AI Cloud OS」を搭載した国内GPUクラウド事業を開始する予定で、NVIDIA GB200 NVL72などを含む計算基盤を提供する[4]。これらは、必ずしも米国ハイパースケーラーのCapacity Blockと同じ土俵で価格交渉するのではなく、国内データセンターに立地し円建てで契約できる調達先を確保する動きと位置づけられる。
加えて、NTT東日本・さくらインターネット・エクイニクスは2026年6月30日、IOWN APN(低遅延・大容量の光ネットワーク基盤)を用いて石狩と東京の拠点を結ぶ実証の検討開始を発表しており[7]、国内複数拠点をまたいだ分散GPU処理という選択肢も現実味を帯びつつある。単一のハイパースケーラーリージョンに依存しない調達の多様化が、価格変動リスクへの備えとしても機能し得る。
国内事業者を検討する意味は、単価が安いことではない。円建てで契約でき、値上げの通知が英語のブログ記事ではなく営業経由で事前に来るという、調達プロセスの予測可能性のほうにある。時間単価だけを並べて比較すると、この差は表に出てこない。
| 論点 | ハイパースケーラーのCapacity Block | 国内ネオクラウド(さくら・ソフトバンク等) |
|---|---|---|
| 価格変動リスク | 需給に応じて改定(2026年に2度値上げ) | — |
| 通貨 | ドル建てが中心 | 円建て契約が可能 |
| 交渉力 | 大規模契約でないと交渉余地が小さい | 国内事業者との直接交渉がしやすい |
「—」は本稿で確認していない項目。
よくある質問(FAQ)
Q. GPUのCapacity Blockは今後も値上げされますか。
A. AWSは価格を需給に応じて変動させると説明しており、2026年に入ってから2度値上げされました。将来の価格を保証するものではありません。
Q. スポットインスタンスはどんな用途に向いていますか。
A. チェックポイントを確実に取得できる耐障害性の高い学習ジョブなど、途中で中断されても再開できる処理に向いています。
Q. 日本企業はハイパースケーラーと直接価格交渉すべきですか。
A. 大規模な調達量がない場合、交渉力は限られます。国内ネオクラウドとの比較検討も選択肢に含めることが実務的です。
まとめ
2026年に変わったのは価格そのものではなく、価格が動くという事実のほうである。予約単価がオンデマンド単価の何割かで分岐点は決まり、H100では実稼働4割を切れば予約は損、8割を超えれば得という帯に収まる。この計算を1度でもやっておけば、値上げのニュースが出るたびに試算をやり直す必要はなくなる。動かすべきなのは契約先ではなく、ワークロードの棚卸しの粒度である。
出典
[1] https://intuitionlabs.ai/articles/data-center-gpu-pricing-2026[2] https://ecorpit.com/aws-ec2-capacity-blocks-gpu-price-rise-finops-2026/
[3] https://www.networkworld.com/article/4113150/aws-hikes-prices-for-ec2-capacity-blocks-amid-soaring-gpu-demand.html
[4] https://www.softbank.jp/corp/news/press/sbkk/2026/20260525_01/
[5] https://www.sakura.ad.jp/corporate/wp-content/uploads/2026/04/260427-ir_2.pdf
[6] https://aws.amazon.com/ec2/capacityblocks/pricing/
[7] https://www.ntt-east.co.jp/release/detail/20260630_01.html