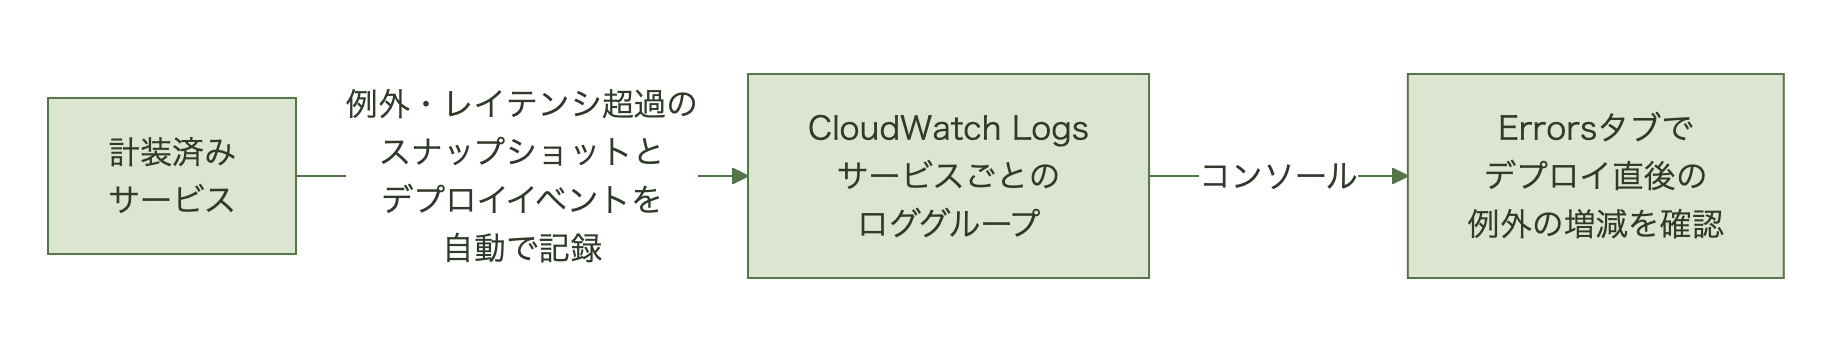
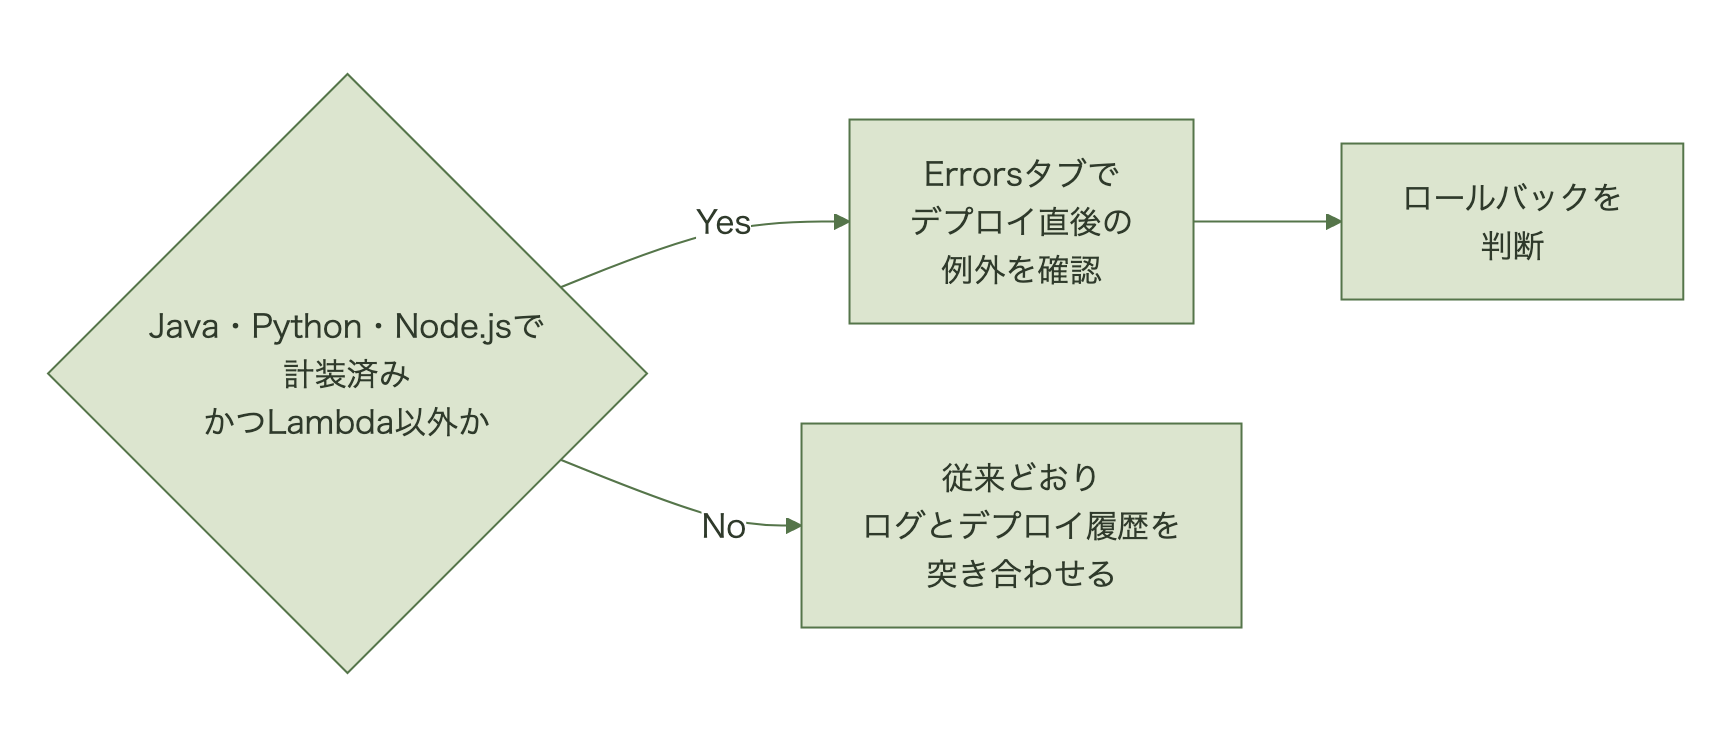
AWSは2026年7月6日、CloudWatch Application Signals(サービスの依存関係と性能を自動で可視化するAWSのアプリケーション監視機能)にService Eventsを追加した[1]。計装済みのサービスについて、例外を投げたリクエストとレイテンシがしきい値(既定5,000ミリ秒)を超えたリクエストのスナップショット、およびデプロイイベントを自動で記録し、コンソールのErrorsタブでデプロイ後に新しい例外が出ていないかを確かめられるようにする[1][2]。
対応言語はJava・Python・Node.jsで、コード変更は要らない。ただしADOT SDKやCloudWatchエージェントの更新が必要で、更新すると既定で有効になり、ログの取り込みと保存に標準料金がかかる[2]。デプロイ履歴とログを別々に開いて時刻を照らし合わせてきた作業の出発点がErrorsタブにまとまる一方、それが原因かどうかの判断は運用担当に残る。
予備知識
- CloudWatch Application Signals: サービス間の依存関係とレイテンシ・エラー率を自動収集し、ダッシュボード化するAWSのアプリケーション監視機能
- ADOT(AWS Distro for OpenTelemetry): AWSが提供するOpenTelemetryのディストリビューション。アプリケーションの計装(トレースやメトリクスを取得できるようにする作業)に使う
- SLO(サービス品質の目標値): エラー率0.1%以内のように、サービスが満たすべき品質の数値目標
- エラーバジェット: SLOを守ったうえで許容できる失敗の残量
- 一次切り分け(トリアージ): 障害発生時に、原因がどの領域にあるかを最初に絞り込む作業
デプロイ直後に増えた例外を追う新機能の背景にある可観測性の考え方を、体系的に理解したいクラウド運用担当に。


Service Eventsは何を自動で集めるのか
ユーザーガイドが挙げるシグナルは4種類ある[2]。
- インシデントスナップショット: 例外発生時か、レイテンシがしきい値を超えたときに取得する。スタックトレース、コールツリー、呼び出し元の情報を含む
- エラーメトリクス: オペレーションごと・例外タイプごとのエラー件数と割合
- デプロイイベント: アプリケーションの起動時と24時間ごとに発行されるマーカー。コミットSHAやデプロイIDを渡すと、その情報が付く
- 関数呼び出しメトリクス: 関数ごとの呼び出し数・所要時間・エラー率。対象パッケージを指定するまでデータは出ない
データはADOT SDKからCloudWatchエージェントを経てCloudWatch Logsとメトリクスに送られ、Logsにはサービスごとに1つのロググループが作られる。Errorsタブには、例外タイプごとの件数の推移を示すチャートと、例外タイプ別の件数と前期間からの変化を並べた表が出る。ユーザーガイドはこのチャートの使い道を、最近になって頻度が変わった例外タイプを見つけることだとしている。例外を選べば、スタックトレースや関連するトレースへ進める[2]。
| 項目 | 従来の一次切り分け | Service Events導入後 |
|---|---|---|
| デプロイ後の例外の確認 | デプロイ履歴とログを別々に開き、時刻を照合 | Errorsタブで例外タイプごとの件数推移と前期間比を確認 |
| 導入に必要な作業 | 例外の集計やデプロイ記録の仕組みを個別に用意 | コード変更なし。SDK・アドオン・エージェントの更新 |
| 対象 | 言語・実行環境を問わない | Java・Python・Node.js。Lambdaでは無効 |
SLOに基づくアラートとカナリアリリースにそれぞれ章を割いた実践編で、Errorsタブで見つけた例外の増加をロールバック判断へつなげる手順を固めたいSREチームに。
SLO運用とインシデント対応がどう変わるか
SLOのエラーバジェットが急に減り始めたとき、最初に知りたいのは直前のデプロイが関係しているかどうかである。Service Eventsが入っていれば、担当チームに問い合わせる前にErrorsタブで、デプロイ後に増えた例外や新しく出た例外を確認し、スタックトレースまで進める。ロールバックするか、別の要因を調べるかの最初の材料は、Errorsタブで得られる。
ただし、画面が示すのは時間の前後関係である。前期間との比較は、同じ時間帯のトラフィック増加や依存先の障害でも同じように動く。デプロイイベントも、発行のきっかけはアプリケーションの起動と24時間の経過である[2]。特定のデプロイと結び付けるには、コミットSHA、デプロイID、デプロイ時刻などを環境変数で渡す。ユーザーガイドにはGitHub ActionsとGitLab CI/CDでの設定例がある[2]。
レイテンシのしきい値もSLOに合わせて見直す対象になる。既定は5,000ミリ秒で、エンドポイントごとに上書きできる[2]。レイテンシのSLOが1秒未満のAPIでは、既定のままだと、例外を伴わない1〜5秒の遅いリクエストはスナップショットの対象にならない。
言語の制約もある。Application Signals自体は.NETやGo、PHP、Rubyにも対応しているが[3]、Service EventsはJava・Python・Node.jsに限られ[2]、同じApplication Signalsの監視下でも言語によってデータの有無が分かれる。なお、データはApplication Signals MCPサーバー経由でAIコーディングアシスタントからも参照でき、ユーザーガイドは直近のリリースが回帰を持ち込んだかの確認を用途に挙げている[2]。
数百のマイクロサービスから日々テラバイト級のログをCloudWatch Logsへ流し込んでいる企業のSRE・運用担当にとって、ログの保存コストは放置しがちな固定費だ。多くの現場では、監査要件や障害調査への備えから「念のため全部Stand[…]
導入の前提とコスト
前提条件として、ADOT SDKを言語ごとの最新版に、CloudWatch Observability EKSアドオンを使う場合はアドオンを最新版に、CloudWatchエージェントを1.300069.0以降に更新する[2]。更新後、Application Signalsが有効なサービスでは次のデータが既定で取得される。止めるには環境変数OTEL_AWS_SERVICE_EVENTS_ENABLEDにfalseを設定する[2]。
| データ | 既定 | 調整できること |
|---|---|---|
| インシデントスナップショット | 有効(例外発生時と5,000ミリ秒超過時) | エンドポイント別のしきい値・対象の絞り込み、1分あたりの上限(既定100件) |
| エラーメトリクス | 有効 | 対象エンドポイントの絞り込み |
| デプロイイベント | 常に発行(起動時と24時間ごと) | コミットSHAやデプロイIDの付与 |
| 関数呼び出しメトリクス | 対象パッケージを指定するまでデータなし | 対象・除外パッケージの指定 |
料金について、What’s NewはService Events専用の料金を示さず、標準のCloudWatch料金が適用されるとしている[1]。データはCloudWatch Logsに記録されて取り込みと保存にLogsの標準料金がかかり[2]、関数呼び出しメトリクスはOpenTelemetryメトリクスとして記録される[1]。スナップショットには1分あたりの上限と、同じエラーはキャプチャウィンドウごとに1件という制限が既定で掛かっているが[2]、例外の多いサービスではログ量が増える。非本番環境で取り込み量を測ってから本番に広げる順序が安全である。
動作環境について、サポートマトリクスはApplication SignalsをAmazon EKS、Kubernetes、Amazon ECS、Amazon EC2でサポート・テスト済みとし、EC2向けの手順はCloudWatchエージェントとADOTに対応した環境なら動作するはずだとしている[3]。EC2向けの手順はオンプレミスのホストにも使えるとされており[4]、AWS上に限らず、オンプレミスのサーバーも対象に入りうる。明記された対象外はLambdaで、Service EventsはLambda環境では自動的に無効になる[2]。
数千人規模でAzure MonitorとDatadogを併用し、年次のコスト監査で監視ツール契約の妥当性を問われる企業のITインフラ担当者は、今回の発表を無視できない。対象はマイクロソフトのAzure Monitor、具体的にはSLI(サ[…]

日本の運用チームでは、SDKの更新がそのまま導入になる
Service Eventsはすべての商用AWSリージョンで提供されており[1]、東京・大阪リージョンのサービスにもそのまま使える。日本語版のユーザーガイドもあり、画面名は[エラー]タブと訳されている[5]。
導入の単位は、Service Eventsの設定ではなく、ADOT SDKとCloudWatchエージェント(EKSではアドオン)の更新である。エージェントやSDKの更新をアプリケーションのリリースとは別の保守作業として進めている運用では、その作業を終えた時点でサービスごとのロググループができ、料金が発生し始める。変更管理にかけるべきは、この更新作業そのものだ。申請には、既定で取得されるデータ(前節の表)、止めるための環境変数、ロググループの保持期間を書いておく。
Lambdaで業務処理を組んでいる構成は対象外である[2]。EKSやECS上のサービスとLambdaが1つの業務フローに混在する場合は、障害対応の手順書で、Errorsタブで確認できるサービスと、ログとデプロイ履歴の突き合わせが残るサービスを分けておく。
まとめ
Service Eventsは、計装済みのJava・Python・Node.jsのサービスについて、例外とレイテンシしきい値超過のスナップショット、デプロイイベントを自動で記録し、デプロイ直後に増えた例外をErrorsタブで確認できるようにする[1][2]。確認できるのは例外の増減とデプロイの前後関係で、原因の見極めは人が行う。
最初の作業は、CIのデプロイ手順にコミットSHAとデプロイIDを渡す環境変数を足すことだ。メタデータがあれば、Errorsタブで見つけた例外の増加を特定のコミットまでたどれる。そのうえで非本番環境のSDKとエージェントを更新し、スナップショットの件数とログの取り込み量を数日分測りながら、エンドポイントごとのレイテンシしきい値をSLOの目標値に合わせて決める。
よくある質問(FAQ)
Q. Service Eventsを使うにはコード変更が必要か。
A. 要らない。ただしADOT SDKと(使っている場合は)EKSアドオンを最新版に、CloudWatchエージェントを1.300069.0以降に更新する必要がある。更新後は既定で有効になり、ログの取り込みと保存に標準料金がかかる。止めるには環境変数OTEL_AWS_SERVICE_EVENTS_ENABLEDにfalseを設定する。
Q. どの言語・環境に対応しているか。
A. 言語はJava・Python・Node.jsで、.NETやGoは対象外である。Lambda環境では自動的に無効になる。
Q. デプロイが原因かどうかを自動で判定してくれるのか。
A. Errorsタブが示すのは例外タイプごとの件数の推移と前期間からの変化で、デプロイイベントは起動時と24時間ごとのマーカーである。デプロイ直後に増えた例外を同じ画面で確認できるが、原因かどうかの判断は運用担当が行う。
Q. 追加料金は発生するか。
A. 専用の料金は示されておらず、標準のCloudWatch料金が適用される。ログの取り込みと保存にはCloudWatch Logsの標準料金がかかる。
出典
[1] CloudWatch Application Signals now automatically captures errors, performance anomalies, and deployment events(AWS What’s New、2026年7月6日)[2] Monitor service events – Amazon CloudWatch
[3] Supported systems – Amazon CloudWatch
[4] Enable your applications on Amazon EC2 – Amazon CloudWatch
[5] サービスイベントのモニタリング – Amazon CloudWatch(日本語版ユーザーガイド)