単一ゾーンに基幹システムを集約している従業員300〜500人規模の製造業や卸売業で、Google Cloud(グーグルのクラウド基盤)の運用を任される情報システム部門の担当者にとって、この障害は他人事ではない。2026年9月1日(米太平洋時間)、Google Cloudのus-central1リージョン(米アイオワ州)で、定例の保守作業中に光ファイバーの経路が次々と抜かれ、us-central1-bゾーンの一部とus-central1-fゾーンのごく一部がネットワークから切り離された[1]。影響は最大4時間11分続き、Googleの障害ページにはCompute Engine、Cloud SQL、BigQueryを含む15製品が並んだ[1]。原因は不正アクセスでも老朽設備でもなく、手作業で組み立てた作業手順の不備だった。本稿は一次レポートをもとに経緯と影響範囲を整理し、単一ゾーン依存を続けるかどうかを判断する材料を示す。
予備知識
- ゾーン: クラウド事業者のデータセンター群を電源系統や建屋単位で細かく分けた区画。1つのゾーンが止まっても他のゾーンは独立して動く設計が前提
- リージョン: 複数のゾーンを束ねた地理的な単位。us-central1は米アイオワ州にあるリージョンで、今回影響を受けたのはその中のbゾーンとfゾーンの一部
- マルチリージョン: 地理的に離れた複数のリージョンにシステムを分散させる構成。Cloud SpannerやCloud Firestoreには、nam5のような複数リージョン構成が用意されている
- SLA: サービス品質保証(Service Level Agreement)。稼働率などの数値をベンダーが契約で約束するもの
何が起きたか——手順の不備が冗長構成ごと切り離した
Googleが9月10日に公開した最終版のインシデントレポートによると、作業はus-central1-bの一部とus-central1-fのごく一部を担うデータセンタールーターの容量増強だった[1]。ルーターは同じ建物内の別々の部屋に冗長配置されており、計画では数日かけて1台ずつ作業し、各段階でトラフィックを迂回させ、ネットワークが完全につながった状態に戻ったことを確かめてから次に進むはずだった[1]。
ところが、手作業で組み立てた手順の不備により、全ルーター分のトランシーバー交換リストが、1台ずつ進める指示のないまま作業員に渡された。手順には、意図しない切断を検知する人とソフトウェアの確認工程も入っていなかった[1]。作業員は13分以内に対象機器すべてのファイバー経路を順に抜き、高密度接続に対応した新しいトランシーバーに交換した。この部品は既存側と互換性がなく、抜いた経路はそのまま接続を失った[1]。抜いたケーブルに光が来ていれば作業を止めるという既存のルールも守られなかった[1]。結果として該当区画の計算資源がネットワークから切り離され、顧客は仮想マシンに到達できず、仮想マシンもゾーンの外へ通信できなくなった[1]。
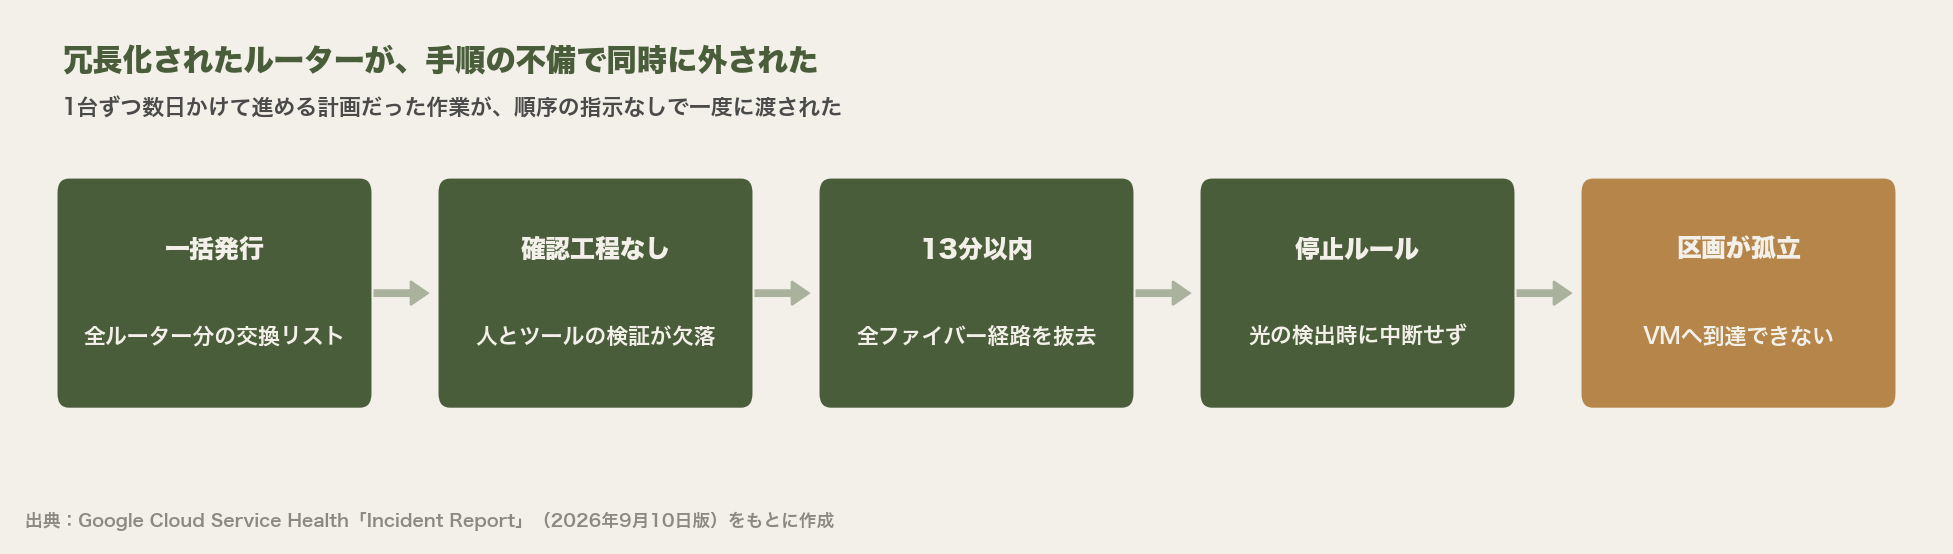
冗長化の設計自体は機能する前提だったが、作業の順序を守らせる仕組みと、途中で止める仕組みの両方が欠けていた。Googleは再発防止策として、ネットワーク更新作業を自動で順序制御する仕組みへの移行(リージョン単位の作業は2025年に完了、ゾーン単位は移行中)や、稼働中のファイバーが抜かれたときに作業を止める警告の導入を挙げている[1]。
Google自身が信頼性をどう設計し運用しているかを知るなら、次の一冊が原典になる。


影響範囲とタイムラインを数字で見る
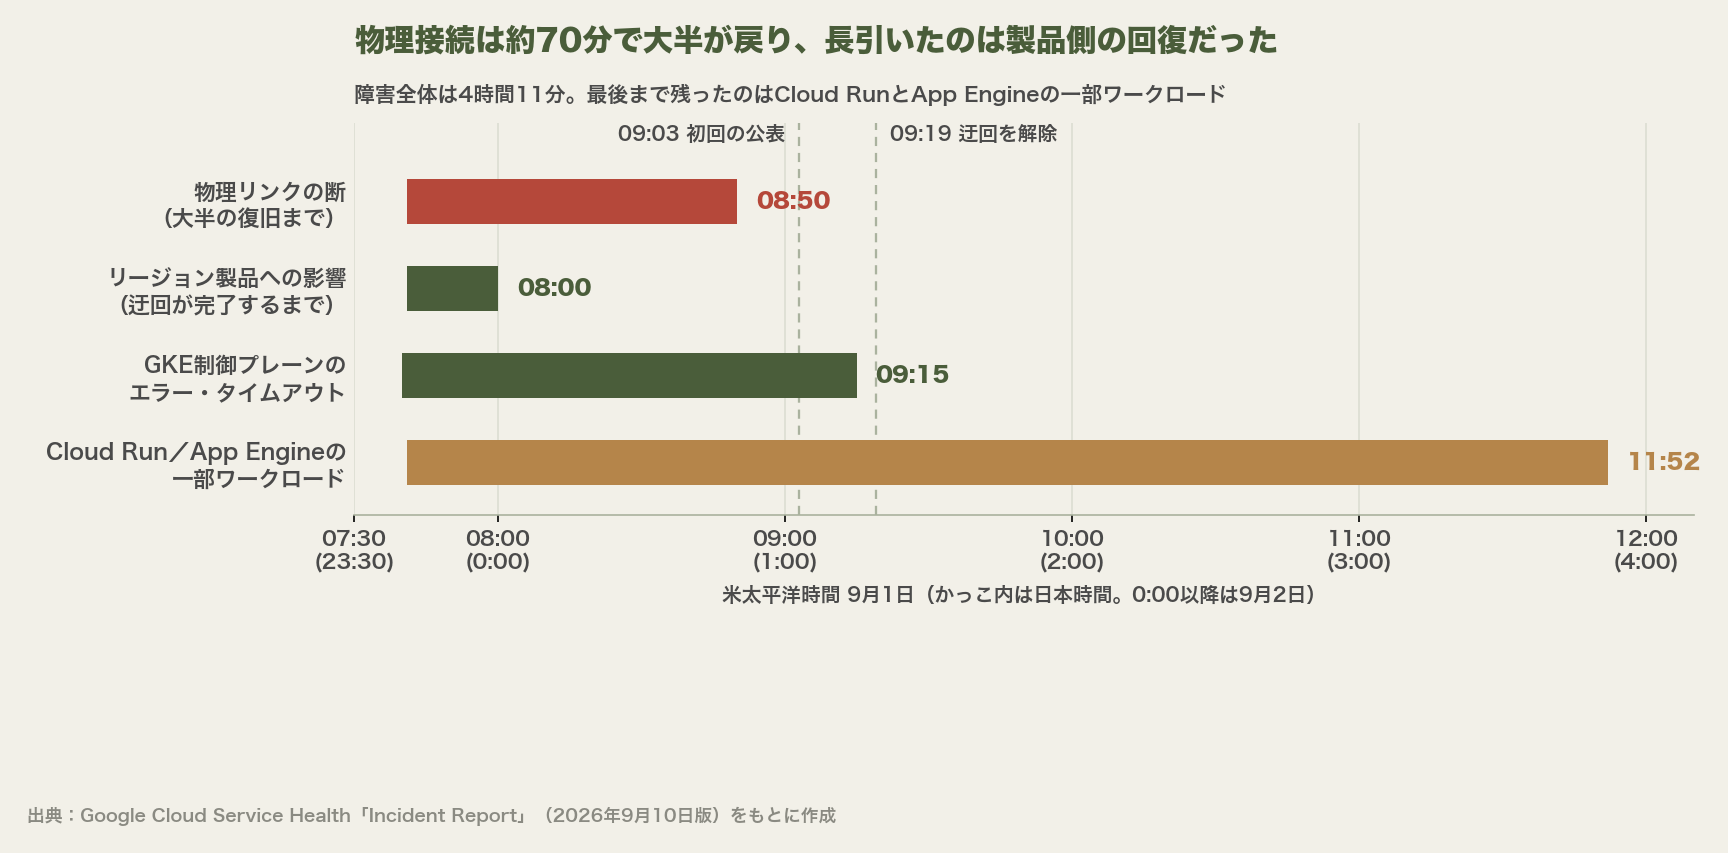
障害は米太平洋時間の7時41分に始まり、11時52分にほぼすべてのサービスの回復が確認された。所要時間は4時間11分だ[1]。Googleの障害ページが影響製品として挙げたのは15製品で、最終レポートの詳細欄にはCloud Firestore、Cloud NAT、Cloud Interconnectなども加わる[1]。影響を受けた区画に資源を置いていた顧客では、ゾーン単位の製品がすべて影響を受けた[1]。
ただし、4時間11分のあいだ全体が止まっていたわけではない。エンジニアは7時45分と8時にトラフィックを迂回させ、リージョン単位の製品への影響は、GKEとCloud Run/App Engineを除いて8時までに収まった。8時50分には物理接続の大半が復旧し、9時19分に迂回を解除している[1]。長引いたのは製品側の回復だ。GKEのクラスタ制御プレーンでは9時15分までエラーとタイムアウトが続き、Cloud RunとApp Engineの一部ワークロードは11時52分まで性能の低下が残った[1]。配線が戻ってから、各サービスが元の状態に戻るまでにさらに約3時間かかった計算になる。なお、Googleが障害ページで最初に公表したのは9時3分で、発生から82分後だった[1]。
2026年7月15日(太平洋夏時間、日本時間では16日早朝)、Google Cloud(グーグルが提供するクラウド基盤サービス)のオランダ拠点で電源網の異常が発生し、冷却設備の停止を経て、europe-west4-a(オランダに置かれたア[…]
単一ゾーンとマルチゾーン、マルチリージョンのトレードオフ
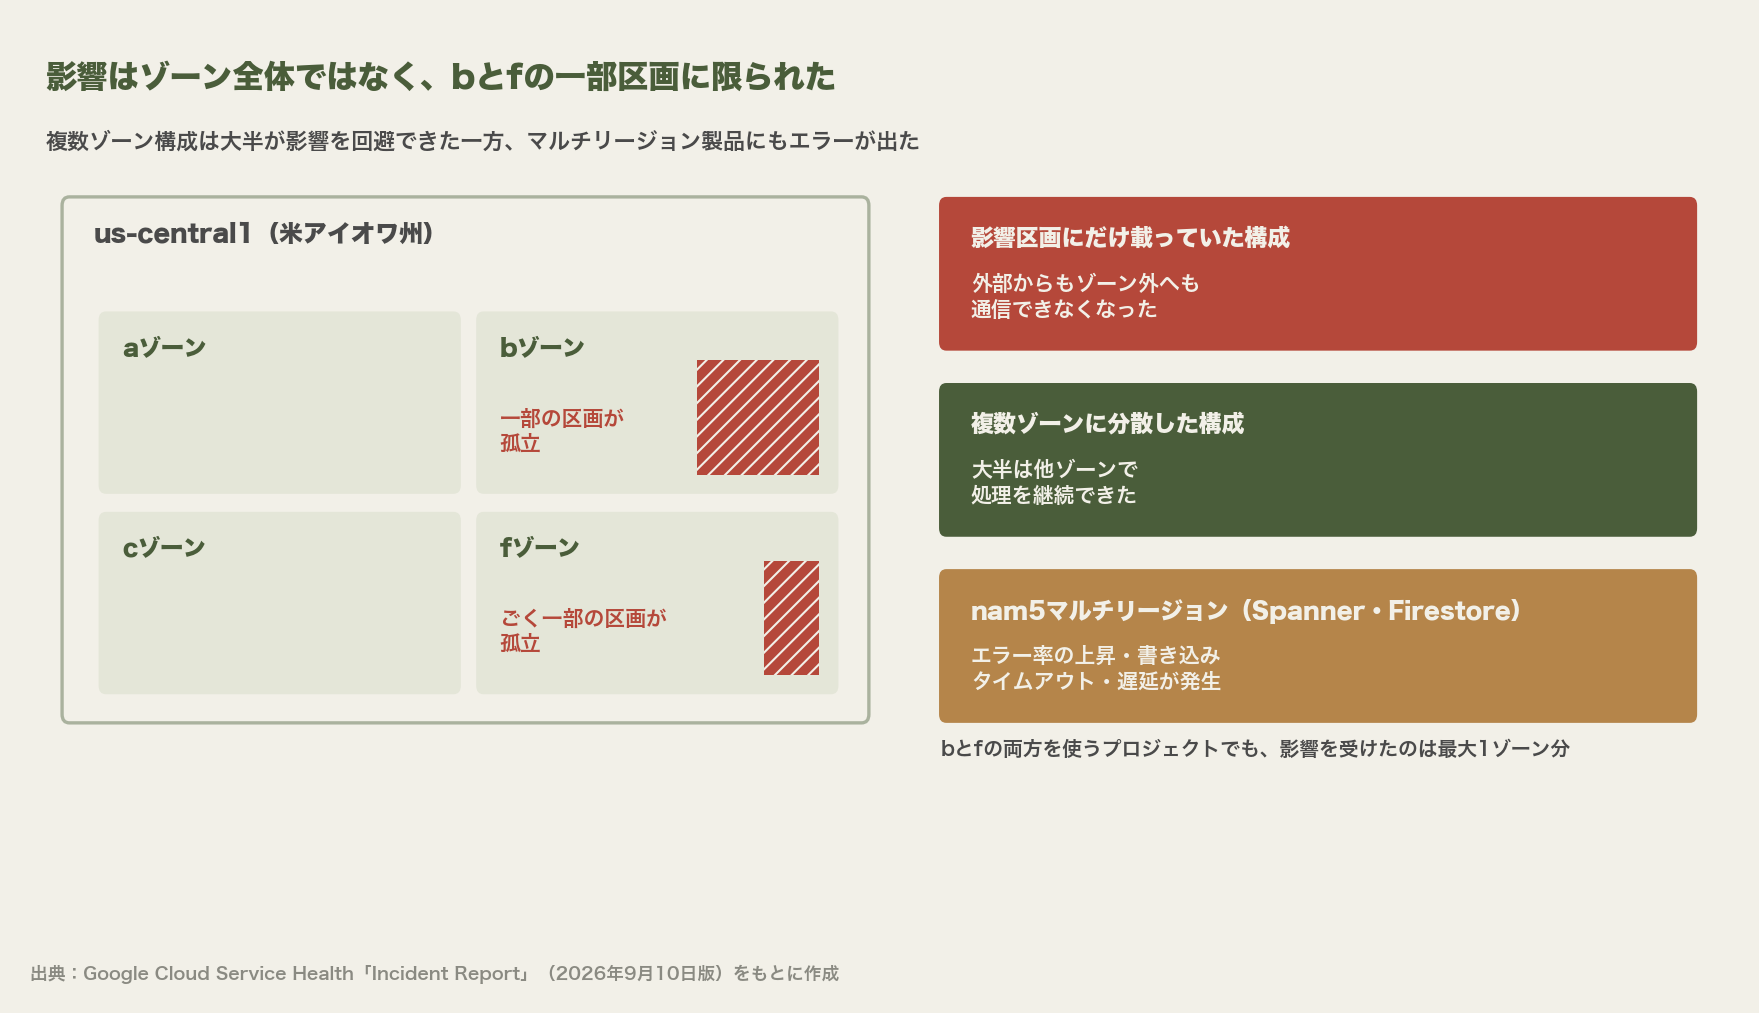
今回、結果を分けたのは構成だった。一次レポートは、影響が特定のクラスタに限られていたため、us-central1の他ゾーンに正しく冗長化していた複数ゾーン構成は物理障害の大半を回避し、トラフィックを処理し続けられたとしている[1]。bとfの両方にリソースを持つプロジェクトでも、影響を受けたデータセンターに載っていたのは最大1ゾーン分だった[1]。一方で、nam5マルチリージョン構成のCloud SpannerとCloud Firestoreでは、影響ゾーンで動く構成要素との接続が切れたことで、エラー率の上昇や書き込みのタイムアウト、遅延が起きた[1]。リージョンをまたげばゾーン障害の影響を受けない、とは言い切れない。
| 構成 | 想定する障害 | 今回の結果 | 追加コストの目安 | 運用の複雑さ |
|---|---|---|---|---|
| 単一ゾーン | なし | 影響区画に載っていれば通信不能 | なし | 低い |
| 同一リージョン内マルチゾーン | ゾーン単位の障害 | 大半は影響を回避 | 中(インスタンス複製・ロードバランサ) | 中程度 |
| マルチリージョン | リージョン単位の障害 | nam5のSpanner・Firestoreでエラー率が上昇 | 高(データ同期・帯域) | 高い |
どこまで投資するかは、システムが止まったときの1時間あたりの損失額と、マルチゾーン・マルチリージョン化の追加コストを比較して決める。全システムを一律にマルチリージョン化する必要はなく、止まると事業影響が大きい基幹システムから優先順位をつけるのが現実的だ。
2026年5月7日、米暗号資産取引所のCoinbaseが約8時間にわたり取引停止に陥った。原因はAWS(Amazon Web Services)の米バージニア北部リージョンus-east-1で起きた、1つのアベイラビリティゾーン(AZ、独[…]

点検すべき項目と投資判断の材料
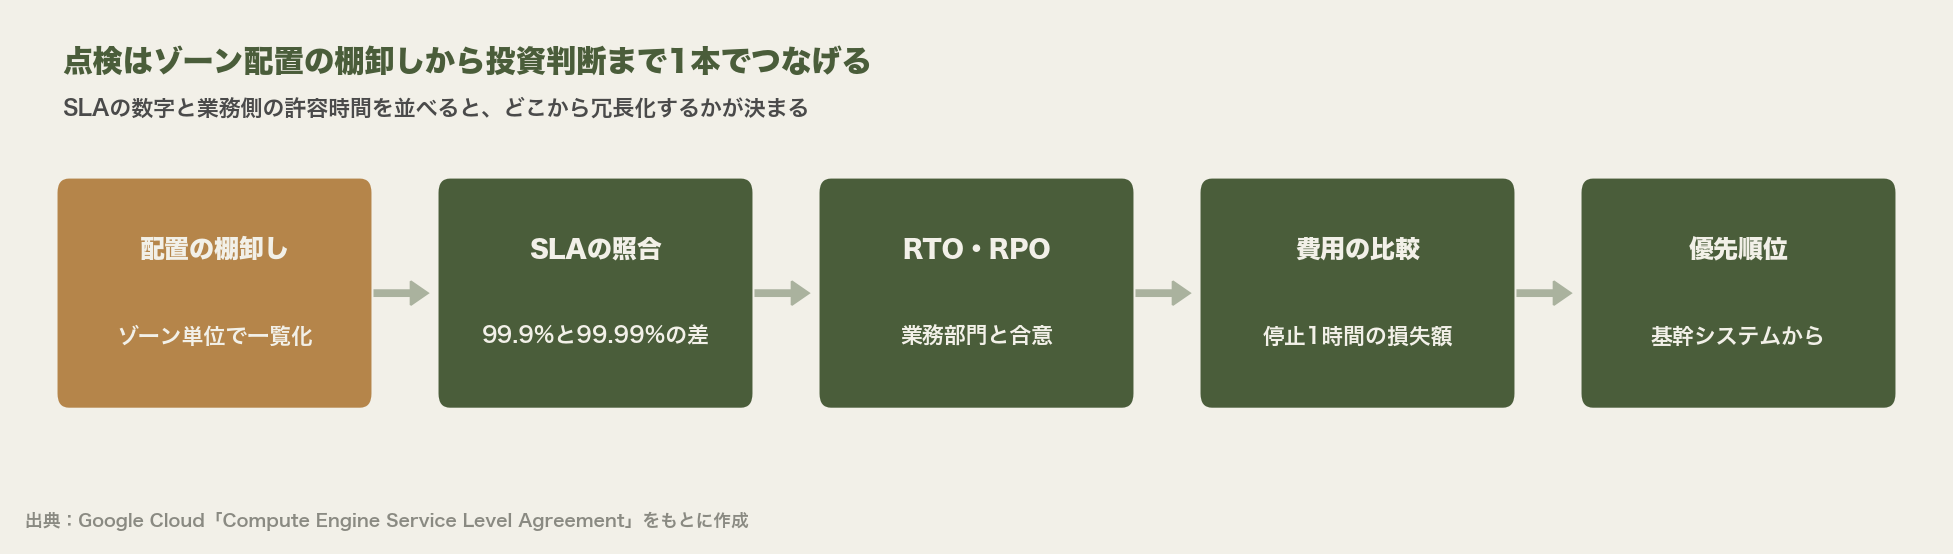
まず、自社システムがどのリージョンのどのゾーンに載っているかを棚卸しする。今回の影響はbとfにまたがったため、us-central1を使っている場合は両方を確認する。
次にSLAを照らし合わせる。Compute EngineのSLAは、複数ゾーンに配置したインスタンスで月間稼働率99.99%以上、1台のインスタンス(メモリ最適化タイプ以外)で99.9%以上だ[2]。99.9%は30日換算で約43分の停止に相当し、今回の4時間11分はその約6倍にあたる。しかも、目標を下回ったときに受けられるのは利用料金のクレジットで、SLAはそれを唯一の救済と定めている[2]。停止による事業上の損失を埋めるものではない点を踏まえて、事業影響とのギャップを確認する。
続いて、単一ゾーンに置かれた基幹システムについて、目標復旧時間(RTO)と目標復旧時点(RPO)を業務部門と合意する。RTOは停止からどれだけの時間で復旧させるか、RPOはどの時点までのデータを取り戻せればよいかを示す。最後に、マルチゾーン・マルチリージョン化の見積もりを取り、停止1時間あたりの損失額と比べて投資の優先順位を決める。
ゾーンとリージョンの違いを含め、可用性設計の基礎を体系的に確かめたい場合は次の一冊が向く。

国内の情シス部門はこの事象をどう読むべきか
日本時間に直すと、障害は9月1日23時41分から9月2日3時52分までで、Googleの初回公表は2日の1時3分だった。夜間バッチやバックアップが動く時間帯に重なり、担当者が不在の時間でもある。クラウド事業者の公表を待たずに、自社の監視で異常に気づいて一次対応できる体制かどうかが問われる。
米国リージョンを使っていないつもりでも、確認は要る。Cloud Functions for Firebaseは、イベント駆動の関数を通常はトリガー元のデータがあるリージョンに配置し、それが決まらない場合はus-central1に配置する[3]。既定のまま作った関数や検証用の環境が、気づかないうちにus-central1で動いていることがある。
構築と運用をSIerに委託していて、ゾーン配置の一覧を自社で持っていない場合は、委託先にプロジェクトごとのリージョン・ゾーン配置を出してもらい、基幹システムと突き合わせる。
| 観点 | 今回の事象 | 日本企業での確認ポイント |
|---|---|---|
| 発生時間帯 | 日本時間の深夜から未明(9/1 23:41〜9/2 3:52) | 夜間の監視と一次対応の体制 |
| 意図しない配置 | Firebaseの関数などはus-central1に置かれることがある | 米国リージョンのリソースも棚卸しに含める |
| 委託構成 | ゾーン配置の情報がSIer側にある | 委託先からゾーン配置の一覧を受け取る |
情シス部門の次の一歩は、委託先を含めて、プロジェクトごとのリージョン・ゾーン配置を1か月以内に一覧にすることだ。意思決定者の判断材料は、マルチゾーン化の見積コストと、停止1時間あたりの事業損失額を並べて比較することに尽きる。
まとめ
今回の障害の核心は、悪意ある攻撃ではなく、作業の順序を守らせる仕組みと途中で止める仕組みが欠けていたことにある。影響はゾーン全体ではなくbとfの一部区画に限られ、複数ゾーン構成の大半は影響を回避した。一方で、単一ゾーンで影響区画に載っていたシステムは通信できなくなり、マルチリージョン製品の一部にもエラーが出た。情報システム部門の次の一手は、自社の基幹システムがどのゾーンに集中しているかを棚卸しすることだ。意思決定者は、マルチゾーン・マルチリージョン化の追加コストと停止時の事業損失額を比較した資料を用意し、投資の優先順位を判断する。単一ゾーンで動いていること自体が悪いのではなく、それを知らずに運用していることが最大のリスクだ。
よくある質問(FAQ)
Q1. Google Cloudを使っていれば必ずマルチリージョンにすべきですか?
すべてのシステムを一律にマルチリージョン化する必要はありません。止まったときの事業影響が大きい基幹システムから優先し、コストと影響額を比較して判断します。今回のように、マルチリージョン構成の製品にもエラーが出ることはあります。
Q2. 自社がus-central1-bやus-central1-fを使っているかはどう確認しますか?
Google Cloudのコンソールで、稼働中のリソース(Compute Engine・Cloud SQLなど)のゾーン設定を確認します。Compute Engineなら gcloud compute instances list の出力にゾーンの列があります。Firebaseの関数は、Firebaseコンソールか firebase functions:list でリージョンを確認できます[3]。契約しているSIerに棚卸しを依頼する方法もあります。
Q3. AWSやAzureでも同じような障害は起きますか?
どのクラウド事業者でも物理的な保守作業は発生するため、同種のリスクはゼロではありません。事業者を問わず、単一ゾーン依存の点検は必要です。