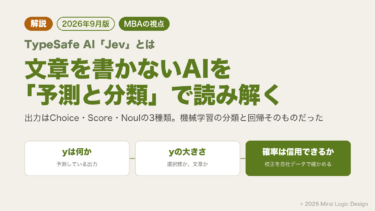
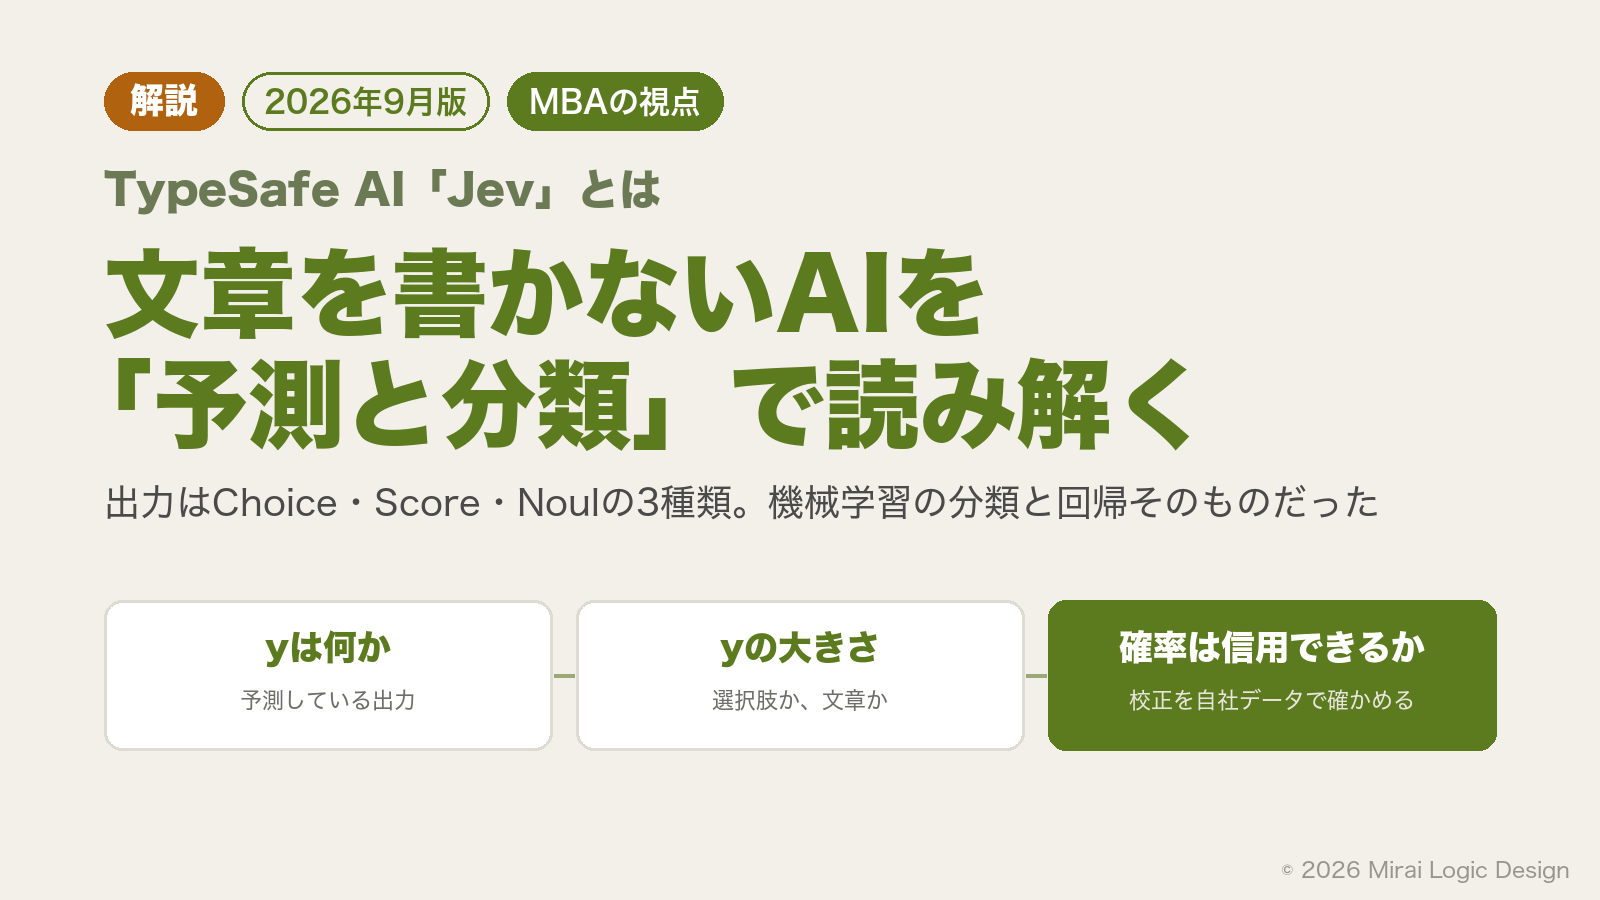
Jevとは、米国のTypeSafe AIが2026年9月15日に公開した、文章を生成せず、選択・評価・確率だけを返すAIです。開発元は、自社の比較タスクで既存のLLMより約190倍速く、約440倍安く処理できたと発表しています。ただし開発元自身、この値は実運用で得られる効果の上限に近いと注記しています。
このニュースを読んで最初に感じたのは、新しさよりも既視感でした。MBAのAI・データサイエンスの講義で最初に教わったのは「機械学習が扱うイシューは予測であり、中身は分類と回帰である」という整理です。生成AIの最前線が、その基本に戻ってきたように見えました。
なぜ今さらAIを学ぼうと思ったのか IT業界に携わって約30年。日々なんらかのIT情報にかかわっている。 そんな私でも、「AIって結局何なの?」と聞かれたら正直に答えられなかった。 ニュースで[…]
この記事では、Jevの仕組みを一次情報で整理したうえで、講義で学んだ予測と分類の見方を当てはめると何が見えるかを説明します。
| この記事の要点 | 内容 |
|---|---|
| Jevの出力 | 選択(Choice)・評価(Score)・確率(Noul)の3種類だけ |
| 機械学習で言えば | 多クラス分類・回帰(順序付き分類)・二値分類そのもの |
| 新しい点 | タスクの種類ではなく、訓練なしでリクエストごとに分類器を定義できる点 |
| MBAとの接点 | アルゴリズムが汎用品になるほど、イシュー設定・仮説・評価の比重が上がる |
Jevの基本情報
開発元と公開時期
TypeSafe AIは米国のAIスタートアップです。創業者のDiogo Almeida氏はOpenAIで、言語モデルが指示に従い対話できるようにする手法の開発に携わり、その研究はChatGPTの土台になりました。開発元のドキュメントは同氏を、InstructGPTやChatGPTの学習に使われたRLHF(人間のフィードバックによる強化学習)の共同発明者と紹介しています。
同社は約2年のステルス期間を経て、2026年9月15日にJevを早期アクセスで公開しました。5日後の9月20日(米国時間)には待機リストを外し、誰でも使える状態になっています。Jevは同社が「System Oneモデル」と呼ぶ新しい種類のモデルの第1弾です。名前は、人間の速く直感的な思考「システム1」と、遅く熟考する「システム2」の区別に由来します。
創業者自身による公開時の投稿です。
After co-inventing ChatGPT, I kept asking myself: why have superhuman chat models not led to AGI?
I’ve spent the last 2 years in stealth building a new way to train models (RLCD), and a new type of frontier AI model that we are releasing today: Jev
• 20-200x faster
• 40-400x— Diogo Almeida (@CompleteSkeptic) 元投稿を見る
Jevが返す3種類の出力
Jevの入力は従来のLLMと同じく文章です。問い合わせの本文、ログ、システムの状態などを読みます。違うのは出力で、返せるのは次の3種類だけです。
| 出力の型 | 内容 | 返ってくる値 |
|---|---|---|
| Choice | 用意した選択肢から一つを選ぶ | 選んだ選択肢、選択肢ごとの確率、確信度 |
| Score | 段階を定義した基準で評価する | 評価した段階、段階ごとの確率、確信度 |
| Noul | ある文が真である確率を返す | 0〜1の値 |
3種類の質問は1回の呼び出しに混ぜて入れられ、それぞれが並列かつ独立に評価されます。料金は入力トークンだけにかかり、100万トークンあたり0.042ドルです。出力トークンは無料とされています。
LLMとの違い
| 観点 | 従来のLLM | Jev |
|---|---|---|
| 出力 | 文章 | 選択・評価・確率 |
| 理由の説明 | できる | できない |
| 出力形式 | 揺れることがある | 定義した型に固定 |
| 複数の質問 | 1件ずつ、または長い出力で対応 | 1回の呼び出しで並列に評価 |
| 向く用途 | 文章作成、要約、対話 | 分類、振り分け、判定 |
開発元自身も、文章の生成が必要なら別のモデルを使うよう案内しています。JevはLLMの置き換えではなく、LLMとは別の部品です。
中身は既存の有名モデルなのか
JevはGPTやLlamaのような既存の有名モデルを、そのまま名前を変えて出したものではありません。開発元は、新しいモデル構造、新しいサンプラー(出力の取り出し方)、新しい学習方法(RLCD)の3つを組み合わせて作った独自のモデルだと説明しています。公式サイトのFAQでも、「Jevは小さなLLMなのか」という問いに、「小さくもなく、LLMでもない」と答えています。
一方で公式ドキュメントは、RLCDを「事前学習済みの言語モデルを調整する3つ目の方法」と位置づけています。1つ目はChatGPTを生んだRLHF、2つ目は推論モデルを生んだRLVRです。言語を理解する土台として事前学習済みの言語モデルを使い、その上にRLCDで判断に特化した学習を重ねている可能性があります。ただし、土台がどのモデルなのか、自社で一から事前学習したのかは、2026年9月時点で公開されていません。
機械学習の基本:AIの仕事は予測である
イシューは分類と回帰に分かれる
講義の初回は、機械学習で扱うイシューは予測であり、その中身は分類と回帰に分かれる、という整理から入りました。入力xから出力yを求める関数y=f(x)を、データから見つけるのが機械学習です。講義資料には「すべての道は(たぶん)予測に通じる」という言葉もありました。予測・推定・分類・検知・判別は、広い意味ではすべて予測です。
演習では、タイタニック号の乗客が生存したかどうか、融資先が貸し倒れるかどうか、社員が離職するかどうかを予測しました。いずれも分類の問題です。売上や価格のように連続した数値を予測するのが回帰です。
分類でも、モデルが出しているのは確率
講義で繰り返し強調されたのが、分類であってもモデルが出しているのは確率だという点です。生存か死亡かを答えているように見えても、実際には生存の確率を出していて、どこで線を引いて生存と判定するかは人が決めます。演習で使った分析ツールでは、この線(しきい値)の初期値は0.5でした。
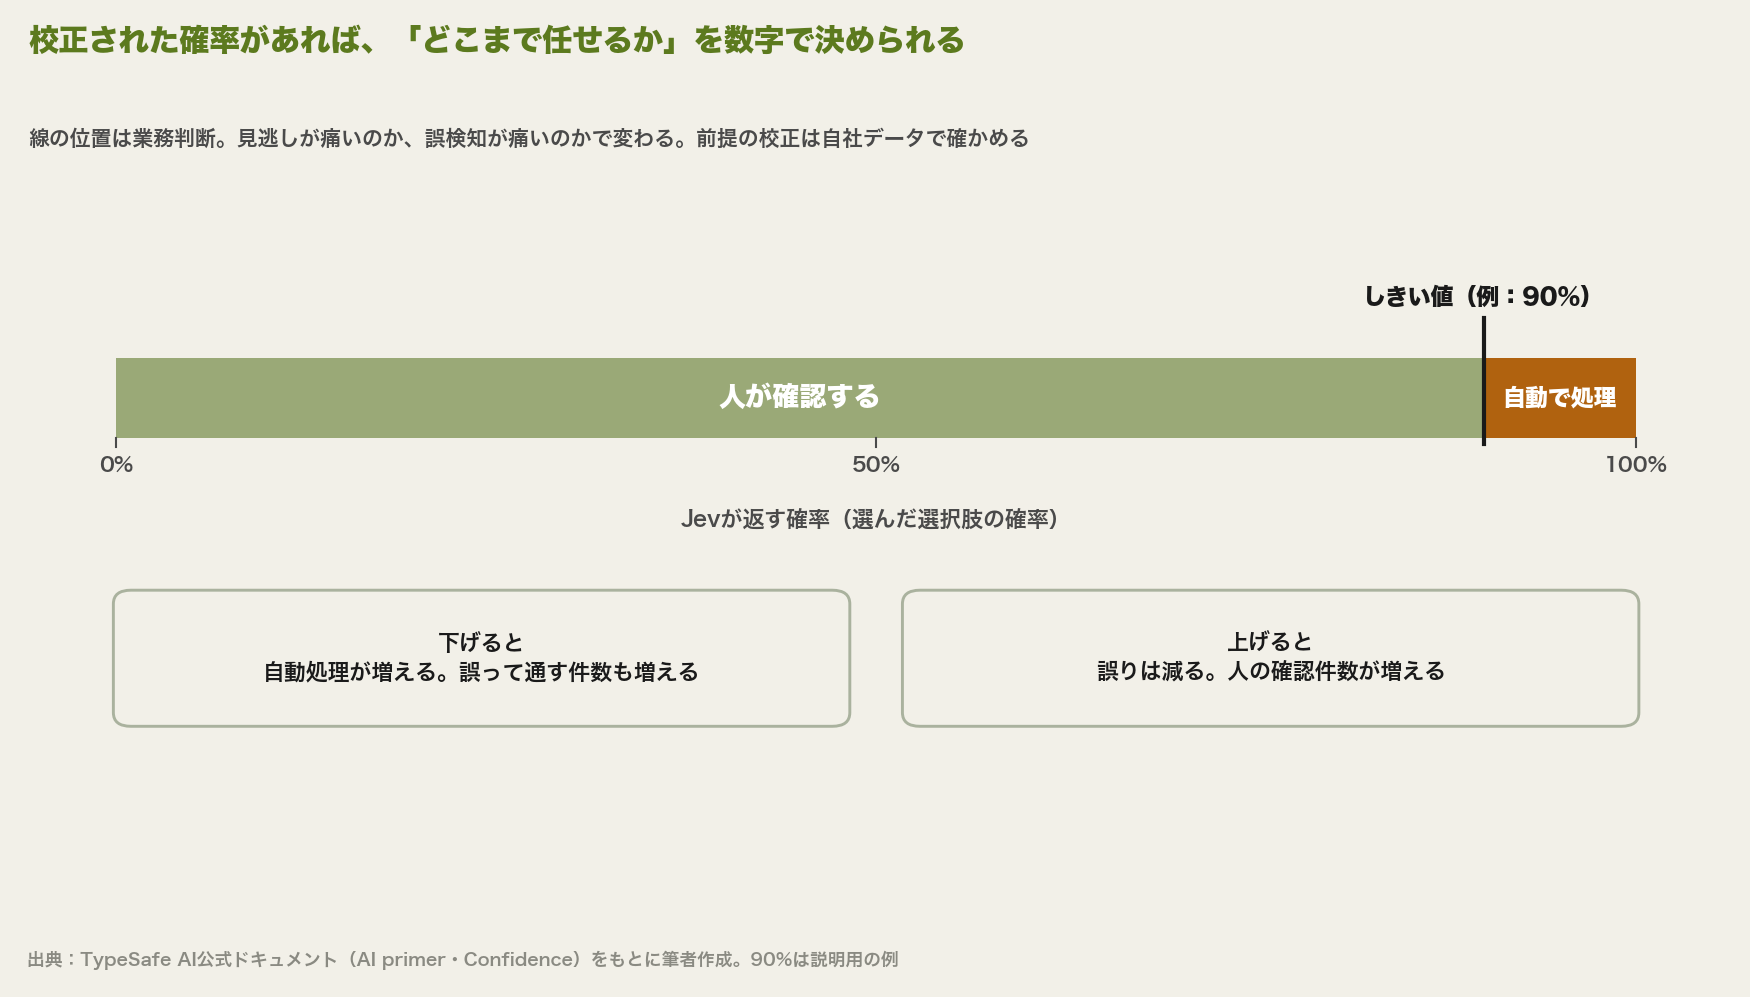
線の位置はビジネスの判断です。線を下げれば拾い漏れは減りますが、誤って拾う件数が増えます。線を上げればその逆になります。見逃しが痛いのか、誤検知が痛いのかによって、正しい位置が変わります。
しきい値の決め方は、講義の内容を整理した別の記事で詳しく扱っています。
前回の記事(機械学習入門③)では、正解率の落とし穴、混同行列、AUCについて書いた。 今回はその続き。モデルを評価できるようになった後に待っているのが、「では実際にどう使うのか」という問いだ。ここが機械学習を学ぶ上で、個人的に一番「[…]
Jevを「予測と分類」で読み解く
Jevの出力は分類と回帰そのもの
この視点でJevの3つの出力を見直すと、すべて見覚えのある形です。
| Jevの出力 | 機械学習での呼び方 | 業務での例 |
|---|---|---|
| Choice | 多クラス分類 | 問い合わせをどの部署に回すか |
| Noul | 二値分類 | 申請に不備があるか |
| Score | 回帰、順序付き分類 | 案件のリスクを5段階で評価 |
Jevは新しい種類のAIというより、分類と回帰という昔からある出力の形を、LLM並みの言語理解に接続したものと捉えられます。
LLMの文章生成も、実は分類の繰り返し
LLMの文章生成も、内部では分類の繰り返しです。講義の生成AIの回では、言語モデルを「次に来る単語の予測モデル」として説明していました。直前までの文から、次に来る1語を語彙全体の中から確率で選ぶ。これを数百回続けた結果が文章になります。
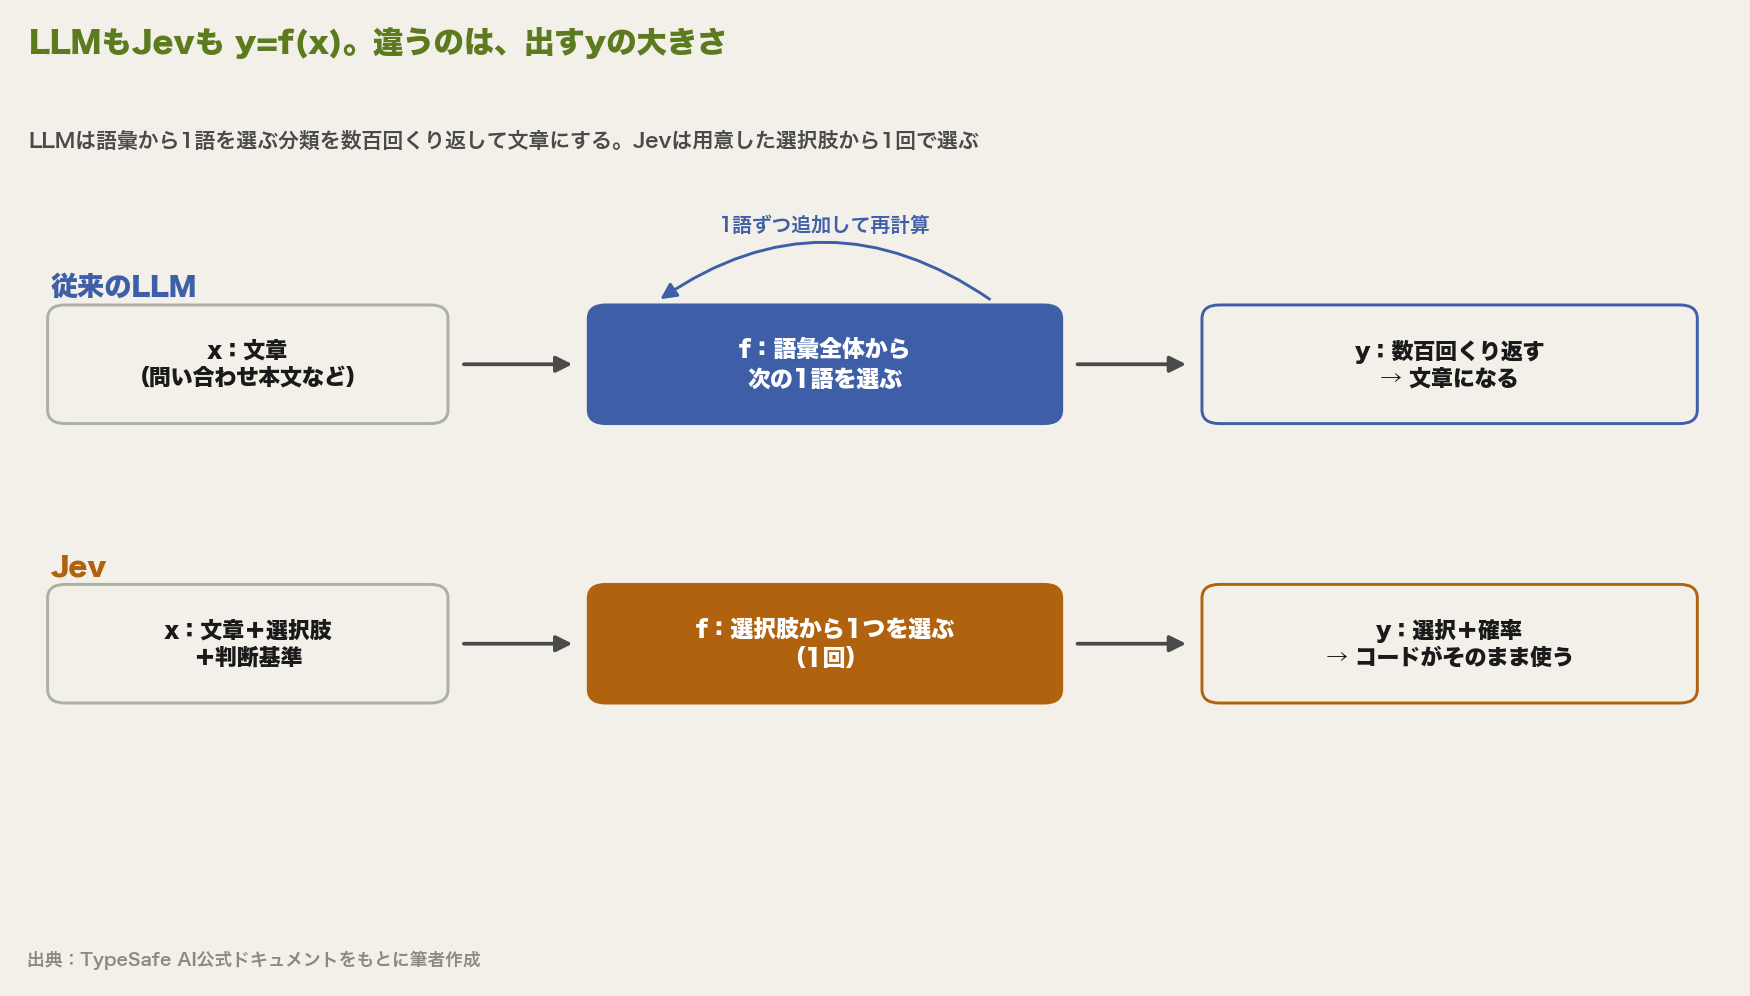
私はこれを、出力yの大きさの違いとして捉えています。LLMは語彙の数だけ選択肢がある分類を何百回も連ね、文章という巨大なyを出す関数です。Jevは、利用者が決めた数個の選択肢から1回で選ぶ、小さなyに絞った関数です。
創業者も、文章を1語ずつ順に生成するLLMと、並列に判定を返すJevを並べた動画で、この違いを「文章を生成できないことと引き換えの速さ」と説明しています。
The gains aren’t free: Jev can’t generate text
Comparing Jev vs LLMs side-by-side makes the trade-off clear
Fun fact: replacing sequential computation with parallel is the same way Transformers leapfrogged RNNs
— Diogo Almeida (@CompleteSkeptic) 元投稿を見る
生成AIの仕組みそのものは、講義の生成AIの回をまとめた記事で解説しています。
前回まで(機械学習入門⑦)は、AIで個人を予測するアプローチのメリットとリスクについて書いた。 今回からは、予測AIとは別の系譜——生成AIの話に入る。MBA講座でもまるごと一回分がこのテーマに割かれていて、「ChatGPTが何をやって[…]

業務で欲しいのは小さなy
業務の判断で本当に欲しいyは、多くの場合小さなものです。承認するか否か、どこへ回すか、緊急かどうか。これまではその答えを得るために、LLMに文章を書かせ、JSONなどの形式に整えさせ、形式が崩れていないかをコードで検証するという遠回りをしていました。Jevは、分類問題を分類問題として直接解いていると言えます。
Jevの何が新しいのか
確率を出すこと自体は新しくない
講義で扱った分類モデルは、当然確率を出します。LLMでも、内部の単語ごとの確率(logprobs)を取り出すことはできます。確率が出ること自体は、Jevの新しさではありません。
新しいのは「訓練不要で、その場で定義できる分類器」
新しいのは分類器の作り方です。講義の演習では、データを集め、前処理をし、特徴量を工夫し、モデルを学習させ、テストデータで評価しました。予測したい対象が変われば、この作業を最初からやり直す必要があります。
Jevでは、選択肢と判断基準をリクエストのたびに渡すだけで、その場で分類器として働きます。開発元によると、Jevは顧客ごとの追加学習をせず、すべての利用者が同じモデルを使います。自社の業務に合わせる手段は、リクエストに書く選択肢と基準です。
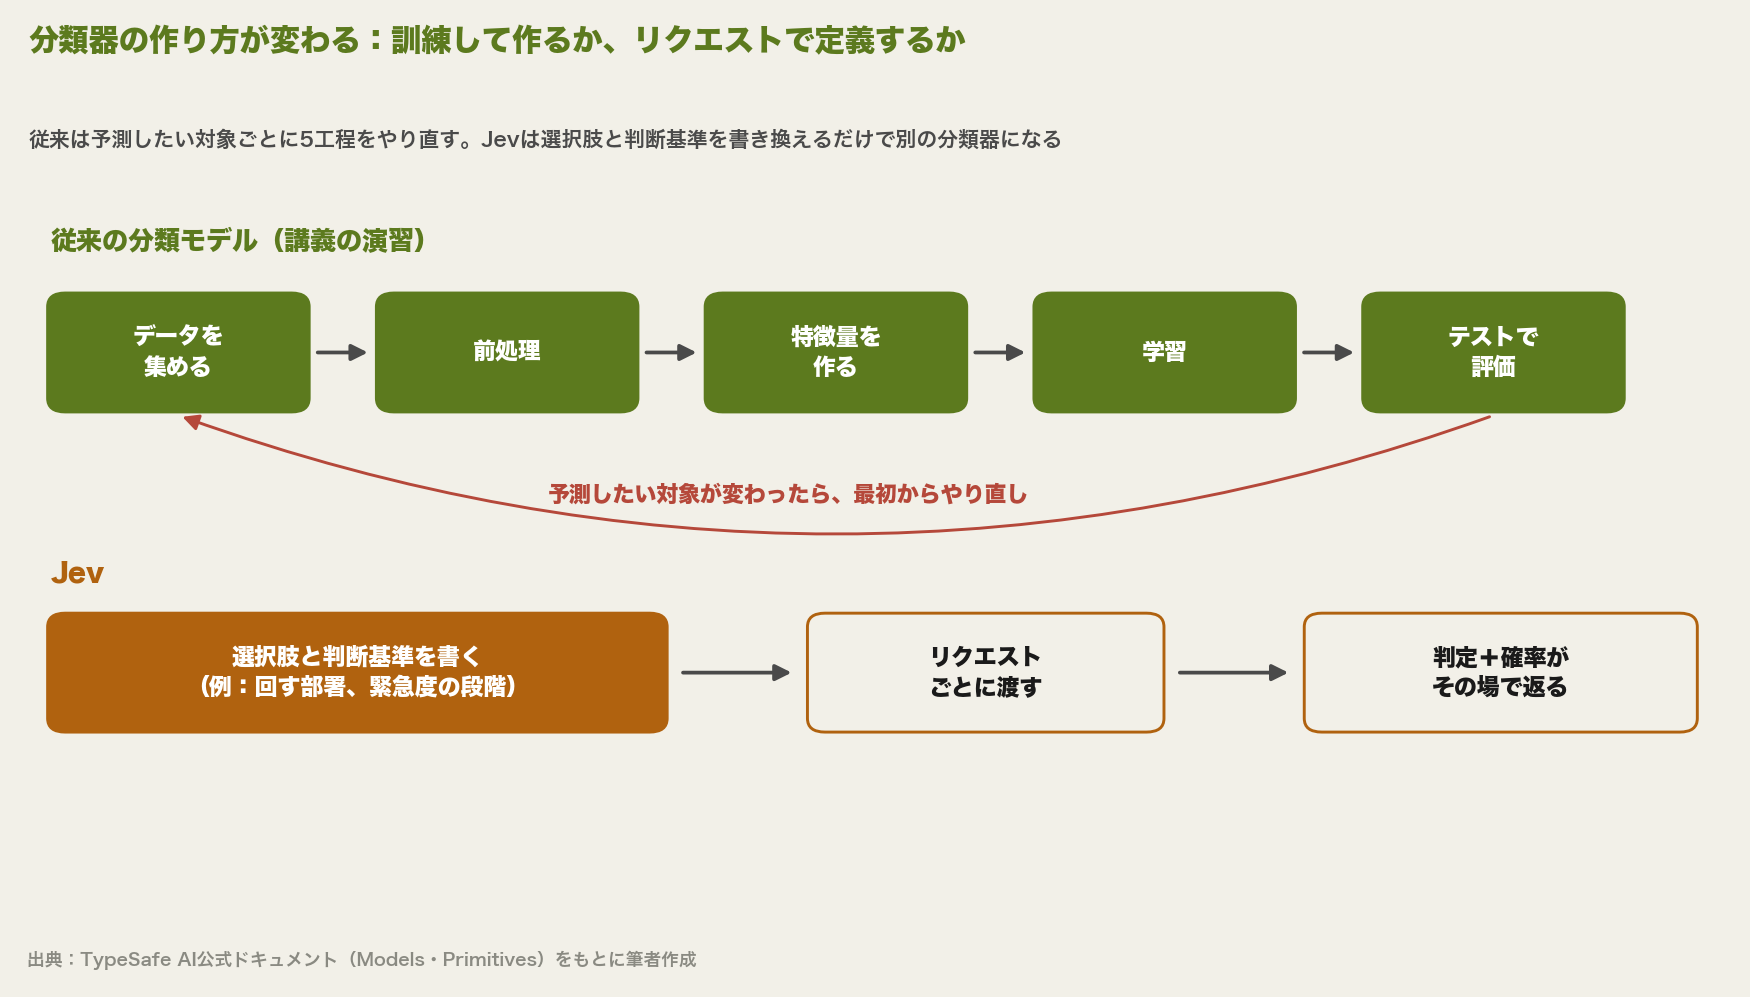
この変化は、講義で示された流れの延長にあります。生成AIの回では、自然言語処理の歴史を「タスクごとに予測モデルを作る時代」から「言語モデルは固定のまま、プロンプトで異なるタスクに対応する時代」への移り変わりとして説明していました。Jevは、この「モデルは固定、タスクはリクエストで定義する」という考え方を、文章生成ではなく分類に持ち込んだものと言えます。
確率を得る手段を並べると、違いがはっきりします。
| 手段 | 確率 | 弱点 |
|---|---|---|
| 従来の分類モデル | 出る | タスクごとに学習データと訓練が必要 |
| LLMのlogprobs | 単語単位で出る | 複数語からなる選択肢の確率を組み立てにくい |
| LLMに確信度を言わせる | 数字は出る | 文章として生成された数字で、正答率と一致する保証はない |
| Jev | 選択肢単位で出る | 校正されていると開発元は主張。自社データでの検証は利用者側の仕事 |
校正された確率が意味するもの
確率が校正されているとは、「90%」と出た判定が実際に9割当たる状態を指します。開発元は、出力する確率が高いほど正答率も高くなるよう学習させた、と説明しています。これが成り立てば、「選んだ選択肢の確率が90%以上なら自動処理、それ未満は人が確認」という線引きがそのまま業務設計に使えます。AIにどこまで任せてよいかを、感覚ではなく数字で決められるようになります。
なお、ChoiceとScoreが返す「確信度」は、確率とは別の値です。確率の分布がどれだけ一つの選択肢に偏っているかを0〜1にまとめたもので、それ自体が「9割当たる」という意味ではありません。開発元は、確信度も自動処理と人の確認を分ける基準に使えると案内しています。
MBAで学んだことは、むしろ効いてくる
分類器を訓練する手間が消えると、機械学習を学んだ意味も薄れるように見えます。実際には逆で、講義で学んだことの比重はむしろ上がると考えています。理由を5つに整理します。
1. イシュー × データ × アルゴリズムの掛け算
講義の最終回で示されたのが、AIで何を勝負すればよいかは「イシュー × データ × アルゴリズム」の掛け算で考えればよい、という整理でした。しかもイシューとデータには「My」が付きます。自分の課題と、自分のデータです。
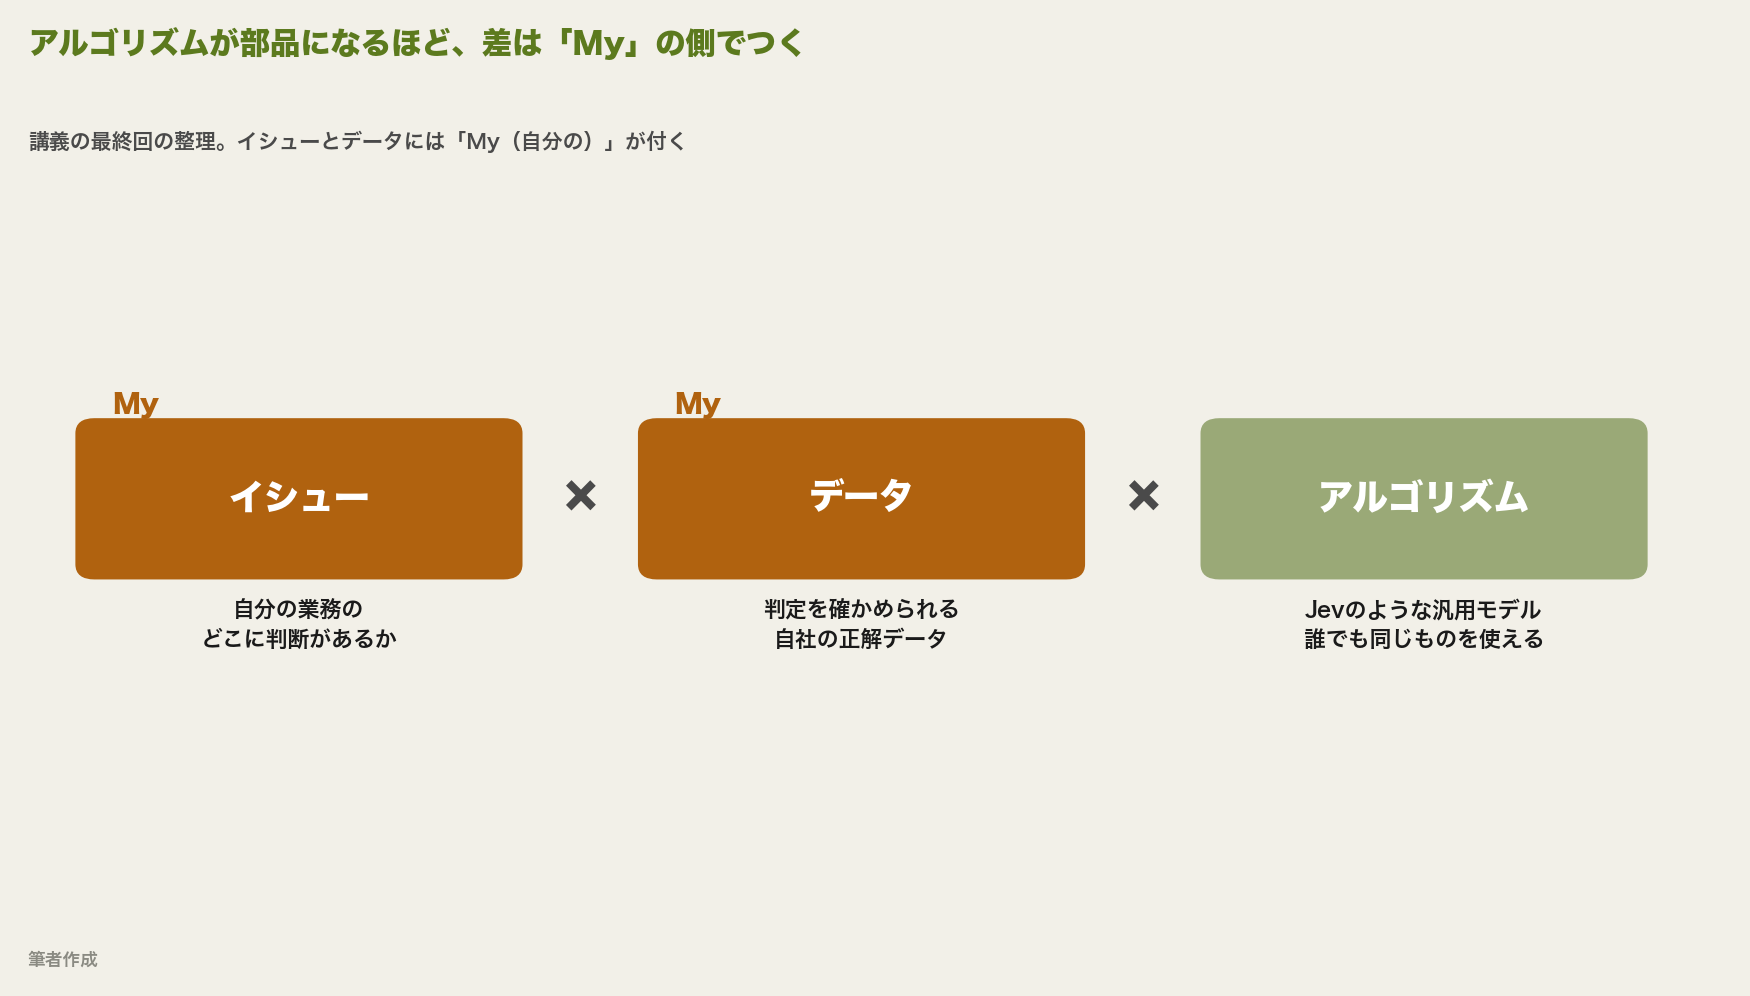
Jevのような汎用モデルが出てくると、アルゴリズムは誰でも使える部品になります。そうなると差がつくのは、自分の業務のどこに判断があるかを見つけるMyイシューと、それを検証できるMyデータの側です。Jevは用意した選択肢の外の答えを返せないので、何を、どの選択肢で分類させるかを誤れば、確率の高い間違いが量産されかねません。開発元も、選択肢が入力を網羅できないおそれがあるときは「該当なし」の選択肢を加えるよう推奨しています。
イシューを見極める考え方は、次の1冊が定番です。


2. 最初に仮説を持つ:選択肢は仮説そのもの
講義では、分析で解くにせよ予測で解くにせよ、最初に仮説を持つことが大切だと繰り返し言われました。演習でも、どの変数が効きそうかの見立てがないまま作ったモデルは、結果の解釈に困りました。
Jevに渡す選択肢と判断基準は、「この業務はこういう軸で判断できるはずだ」という仮説そのものです。仮説の質が、そのまま判定の質になります。
3. 評価:テストデータで確かめ、リコールとプレシジョンを使い分ける
演習で繰り返したのが、学習に使っていないテストデータで予測を検証し、分類ならAUCや混同行列で評価する作業でした。特に、拾うべきものをどれだけ拾えたか(リコール)と、拾ったものがどれだけ当たっていたか(プレシジョン)の違いは、業務設計に直結します。
Jevが「90%」と出した判定が本当に9割当たっているかも、自社のデータで確かめるまでわかりません。過去の判定結果を正解として用意し、Jevの判定と突き合わせる。見逃しと誤検知のどちらが業務上痛いかを考えて、しきい値を決める。演習でやった手順が、そのまま必要になります。
評価の手順を業務の言葉で説明している本として、次の1冊を挙げます。

4. 分析的に解くか、予測的に解くか
MBAで学ぶ問題解決の多くは、因果関係を起点に原因を特定して手を打つ分析的なアプローチです。一方、機械学習は原因を説明しなくても結果を予測し、一件ごとに最適な対応を取る予測的なアプローチです。講義では、この2つの違いと、予測によって問題解決を個別化できることの価値を体感することが一つの狙いでした。
Jevは明確に予測の側の道具です。判定は返しますが、なぜその判定なのかは説明しません。「なぜ問い合わせが増えているのか」「なぜこの申請に不備が多いのか」を掘り下げて打ち手を考えるのは、引き続き人の仕事です。どちらのアプローチで解くべき問題かを見極める力が、道具が増えるほど重要になります。
分析と予測の違いは、講義のケースを使って別の記事で整理しています。
前回の記事(機械学習入門⑥)では、製薬会社の離職問題を題材に、データ探索・フィーチャーエンジニアリング・予測モデル作成の流れを書いた。 今回はその続きとして、「どう打ち手に落とし込むか」「AIを使うことのリスクは何か」という、より経[…]

5. オッカムの剃刀から多次元へ
最終回で印象に残ったのが、講義で紹介された外部の講演資料による対比です。科学は「少ないパラメータで多くの現象を説明する」オッカムの剃刀を良しとしてきた。一方でAIは、多くの要素を多いまま扱う「多次元」の世界で関係を捉えられる。人が理解できる形に単純化しなくても、解ける問題の範囲が広がっている。講義ではこれを、解けるイシューのフロンティアが大きく拡がりつつある、と表現していました。
Jevは、その多次元の判断を安く大量にこなせる部品です。これまで人手では割に合わなかった、一件ごとの細かい振り分けや判定を個別に最適化できるようになります。その範囲がどこまで広がるかを考えるのが、経営側に求められる視点だと思います。
業務で使う際の注意点
開発元は、現行版(jev-1.13)が苦手とする点をドキュメントで公開しています。業務で使う前に押さえておきたいものを整理します。
| 注意点 | 起きること | 対策 |
|---|---|---|
| 別々の質問の整合 | 「返金の依頼か」と「返金以外の依頼か」を別々に聞くと、確率の合計が1を超えることがある | 一つの判断は一つの問い方で聞き、確率どうしの整合はコードの側で取る |
| 文字どおりに読む | 書いた言葉どおりに答え、意図までは汲まない | 判断の条件と境界の例を、判断基準に書き込む |
| 数値と計算 | 数を数える、計算する、日付を比べる判断は苦手 | 計算や比較はコードで行い、Jevには意味の判断だけを任せる |
| 無関係な情報 | 入力に判断と無関係な内容が多いほど精度が下がる | 判断に必要な項目だけに絞ってから渡す |
| 誘導を狙った文章 | 入力に紛れ込んだ指示や誘導で、判定が動くことがある | 基準を明確に書き、運用前に境界のケースを試す |
開発元の例では、同じ問い合わせ文に対して「返金を求めているか」を0.72、「返金以外を求めているか」を0.47と評価し、合計が1.19になりました。別々の質問の確率を足し引きして使わないことが、設計の前提になります。
データの取り扱い条件の確認
Jevは公開されたばかりの外部サービスです。開発元は、利用者のリクエストと応答をモデルの学習に使わないと明記し、企業向けにはデータを保持しない契約(ZDR)も用意しています。それでも、業務データを送る前には、送信先、保存期間、契約条件を自社の基準で確認する必要があります。セキュリティ要件の厳しい組織では、公開情報や匿名化したデータの用途から試すのが安全です。
よくある質問
Jevは文章を書けますか?
書けません。返せるのは選択、評価、確率の3種類だけで、判断の理由も説明できません。開発元も、文章が必要な処理には生成モデルを使うよう案内しています。理由の説明や文章が必要な部分は、従来のLLMと組み合わせて使います。
Jevの中身は、GPTやLlamaなど既存の有名モデルですか?
開発元は、新しいモデル構造・新しいサンプラー・新しい学習方法(RLCD)で作った独自のモデルだと説明しています。公式FAQでも「小さくもなく、LLMでもない」としています。ただしRLCDは、事前学習済みの言語モデルに追加で施す学習方法として説明されています。土台にどの言語モデルを使ったのか、あるいは自社で一から作ったのかは、2026年9月時点で公開されていません。
Jevの名前の由来は?
19世紀の英国の経済学者ウィリアム・スタンレー・ジェボンズに由来します。蒸気機関の効率が上がると石炭の消費がかえって増えた、という「ジェボンズのパラドックス」で知られる人物です。開発元は、AIの判断のコストが下がるほど使い道が桁違いに増える、という見通しをこの名前に込めています。
日本語は使えますか?
使えますが、精度は英語が最も高いと開発元は説明しています。日本語を含むCJK(中国語・日本語・韓国語)の文章も処理できるものの、英語と同じ水準ではありません。日本語の業務で使う場合は、自社の文章で精度を確かめ、確信度を見ながら人の確認に回す設計が前提になります。
料金はいくらですか?
入力トークン100万あたり0.042ドルで、出力トークンは無料です(2026年9月時点の公式ドキュメント)。1回のリクエストで扱える長さは6万4千トークンまでです。
どんな業務に向いていますか?
問い合わせの分類と振り分け、アラートの重要度判定、申請の不備チェックなど、件数が多く、答えが選択肢で決まる判断に向いています。LLMへの入出力を検査するガードレールや、検索結果の絞り込みといった、AIシステムの部品としての使い方も公式に紹介されています。
まとめ
新しいAIが出るたびに、何ができるのかを一から覚え直す必要はありません。
| 見るポイント | Jevの場合 |
|---|---|
| そのAIが予測しているyは何か | 選択・評価・確率 |
| yはどれくらいの大きさか | 利用者が決めた数個の選択肢 |
| 確率はどこまで信用できるか | 校正済みと主張。自社データで確かめる |
この3点を見れば、多くのAIの位置づけは整理できます。
そして、分類器を作る手間がなくなるほど、何を解くか、どう確かめるかという人の仕事の比重が上がります。MBAで学んだのはツールの使い方ではなく、この問いの立て方でした。Jevは、機械学習の基本である予測と分類が、生成AIの時代にも有効な見方であることを改めて確認させてくれる題材でした。
こうした見方を持てるようになったMBAの講義シリーズは、第1回から順に読めます。
なぜ今さらAIを学ぼうと思ったのか IT業界に携わって約30年。日々なんらかのIT情報にかかわっている。 そんな私でも、「AIって結局何なの?」と聞かれたら正直に答えられなかった。 ニュースで[…]
参考
- TypeSafe AI公式ブログ:Introducing System One Models & Jev(2026年9月15日)
- TypeSafe AI公式サイト(FAQ)
- TypeSafe AI公式ドキュメント:Primitives(Choice・Score・Noul)
- TypeSafe AI公式ドキュメント:Models(料金・言語・データの扱い)
- TypeSafe AI公式ドキュメント:Jev 1.13 jaggedness(苦手な処理)
- TypeSafe AI公式ドキュメント:AI primer(RLCDと校正)
- TypeSafe AI公式ドキュメント:Confidence(確信度の定義)
- TypeSafe AI公式ドキュメント:Guardrails for LLMs
- TypeSafe AI公式ドキュメント:Re-ranking