数千人規模の従業員を抱え、年次の内部監査があり、基幹システムの一部をKubernetes上で動かしている企業のプラットフォーム運用担当者を想定する。バックアップジョブのログが毎晩「Completed」と表示され続けていても、それは復元できることの証明にはならない。2026年9月、CNCFアンバサダーのSaiyam Pathak氏とSaloni Narang氏が、PostgreSQLをKubernetes上で動かす環境で3つの障害シナリオを組み、ノートPC上で再現できるラボとして公開した[1]。記事に出てくる端末出力はすべてそのラボでの実測だという。
3つのシナリオが分けて見せるのは、CSIスナップショットやVeleroが出す成功表示がどこまでを示し、どこから先は別の確認が要るかである。あわせて、Kubernetes 1.36で正式版(GA)となったVolumeGroupSnapshot APIが3つ目のシナリオへの答えとして置かれている[1][2]。以下では、何がログで分かり、何が復元テストでしか分からないかを分けていく。
予備知識
- PVC(PersistentVolumeClaim): Podが使う永続ストレージをKubernetesに要求するリソース
- CSI(Container Storage Interface): Kubernetesとストレージ製品をつなぐ標準API
- データムーバー: スナップショットのデータをクラスタ外の保存先へ運ぶバックアップツールの部品
- GitOps: Gitに書いた望ましい状態をクラスタへ自動反映する運用方式
- VolumeGroupSnapshot: ラベルで指定した複数のPVCを同一時点でまとめてスナップショットするKubernetesの標準API
CSIやストレージリソースの基礎から本番運用の勘所まで一冊で押さえたい担当者向け。


バックアップの「完了」表示は何を示しているか
多くのバックアップツールは、処理が最後まで実行されればログに「Completed」と記録する。検証はこの表示の意味をはっきり限定している。Completedというバックアップのフェーズが示すのは、バックアップ処理が完了したことである。アプリケーションが起動すること、期待したデータを含むこと、トラフィックを処理することは証明しない。それを示す証拠になるのは、端から端までの復元テストだけである[1]。
多くの確認は完了表示で止まるが、その次の一歩として、ボリュームのデータが実際に動いたかを見られる。ラボではデータムーバーの進捗に47,989,888バイトが記録されており、この数字はボリュームのデータがクラスタの外へ出て外部ストアに着いたことを示す。この数値を報告できないバックアップツールは精査に値する、というのが検証の指摘である[1]。ただしここで分かるのはデータが外へ出たところまでで、そのデータから復元できるかどうかは含まれない。
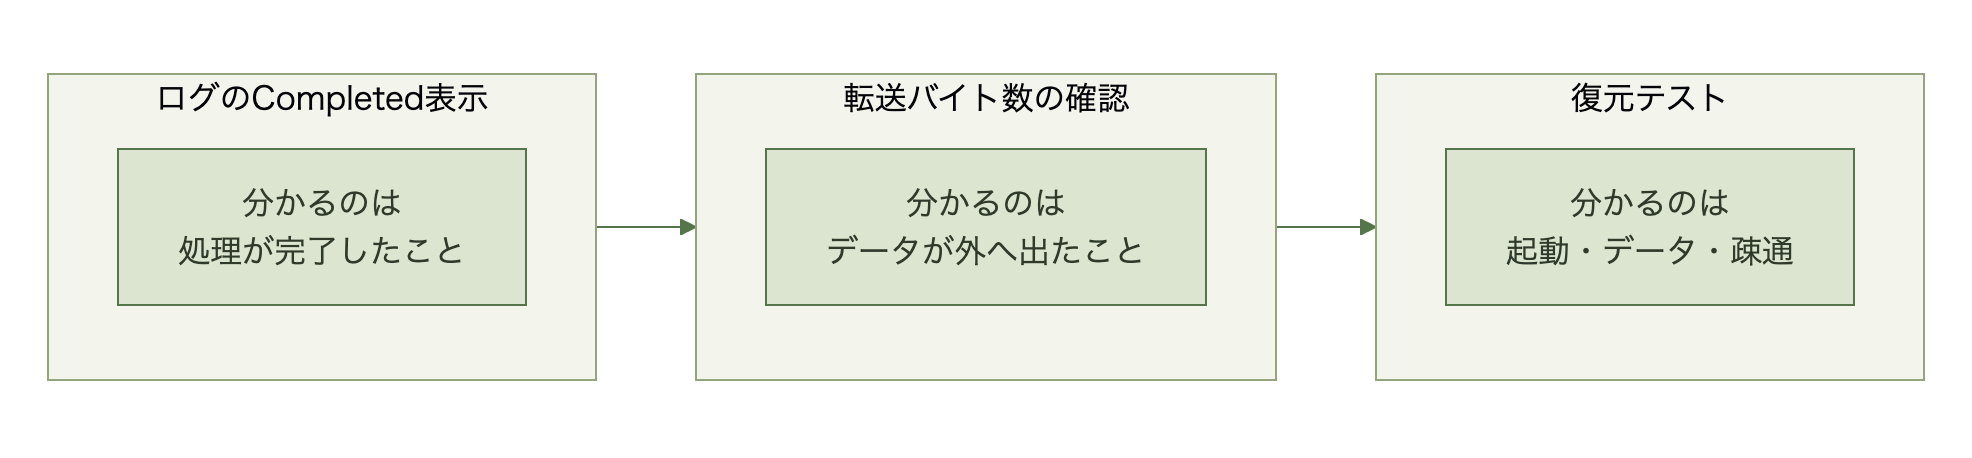
実際、このシナリオの復元自体は成功している。PVCを含めて名前空間を削除したうえで同じバックアップから復元すると、元の4行が約2分で戻った[1]。1つ目のシナリオが示すのは復元の失敗ではなく、完了表示が受け持つ範囲の狭さである。
検証は、この成功例がバックアップツールの自動処理には含まれない3つのことを覆い隠すとも書いている。ボリュームのデータを保護しても、データベースのバックアップがアプリケーション整合になるわけではなく、必要ならフラッシュや静止点のフックを設定する。別のインフラへ復元する場合は、ストレージクラスの対応づけなどの変換を自分で設計してテストする。そして完了表示が示すのはバックアップ操作の完了までで、アプリケーションが起動すること・期待したデータが入っていること・要求に応答できることの証明にはならない。それを示せるのは通しの復旧テストだけである[1]。
復旧の優先順位づけや代替手段の考え方といった、ツールに左右されないDRの原則を押さえたい担当者向け。

GitOpsで復旧したPodはなぜデータが空になるのか
GitOpsはGitに書かれた宣言状態をクラスタへ同期する運用方式で、宣言状態にデータベースの中身は含まれない。検証では本番クラスタの電源を落とし、あらかじめ用意してあった復旧用クラスタでGitからアプリケーションを同期した。同期はSyncedを報告し、StatefulSetは展開され、データベースのPodはRunningかつReadyになり、ダッシュボードはすべて緑になった。そこでデータベースに問い合わせると、テーブルが存在しないというエラーが返る[1]。
故障は起きていない。Gitが持っていたのは宣言だけなので、Kubernetesはマニフェストどおりに新しい空のボリュームをPVCへ割り当てた。Gitは意図を保存し、バックアップは状態を保存する。復旧には両方が要る[1]。
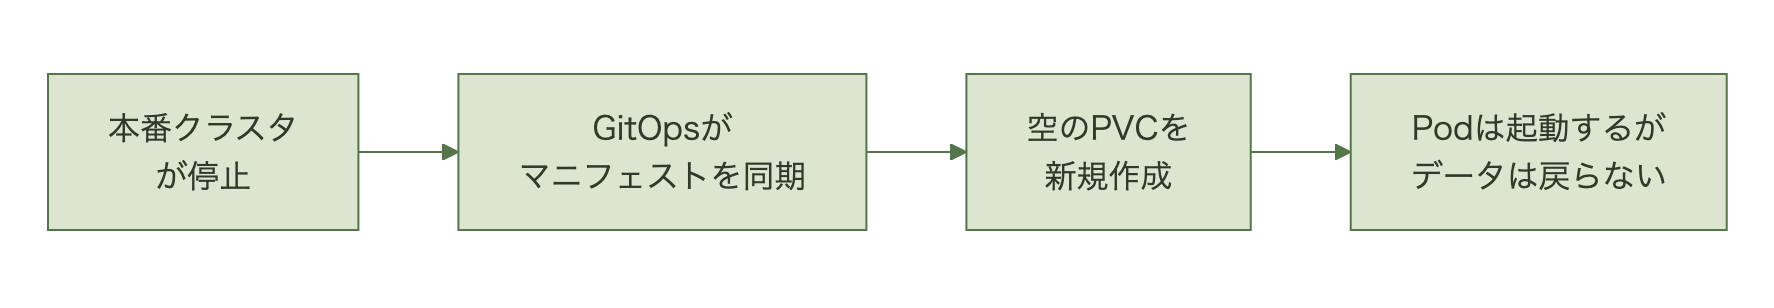
検証ではこの後、同期が作った空のアプリケーションを削除し、バックアップストアからボリュームごと復元し、期待した中身と突き合わせる手順で復旧している。この復元はインフラもまたいでいる。バックアップを取ったノードランタイムと復元先が違うため、復元の移植性は前提にせずテストする対象になる[1]。
所要時間は、本番の電源を落としてから復旧クラスタでデータを検証し終えるまで、初回が4分、手順をなぞった2回目が2分弱だった。ただし検証は、この2つの数字が測っているのはスクリプト化された区間だけだと断っている。本番のRTOはその外側に、検知・判断・トラフィックの切り替え・切り戻しが重なる[1]。
Snowflakeでマネージド型データウェアハウス(DWH)を運用し、内部監査でSLA遵守状況の説明を求められるデータ基盤担当者が本稿の対象読者だ。数百〜数千人規模の情報システム部門で、保守運用をSIerに委託し、障害時の一次対応をベンダ[…]
複数ボリュームのスナップショットがなぜ相互に矛盾するか
実運用のステートフルアプリケーションは複数のボリュームにまたがる。データ本体とWAL、メッセージブローカのパーティション、レプリカセットなどである。ラボのアプリケーションは、注文nを一方のPVCへ、決済nをもう一方のPVCへ毎秒5組ずつ書き、すべての決済に対応する注文があるという不変条件を置いた[1]。
この2つのボリュームを5秒ずらして個別にスナップショットしたところ、2つのスナップショットはどちらもReadyToUseで、単独で見れば完全だった。両方を復元して最後にコミットされた連番を比べると、注文が108352、決済が108377で、25件の決済に対応する注文が存在しない[1]。
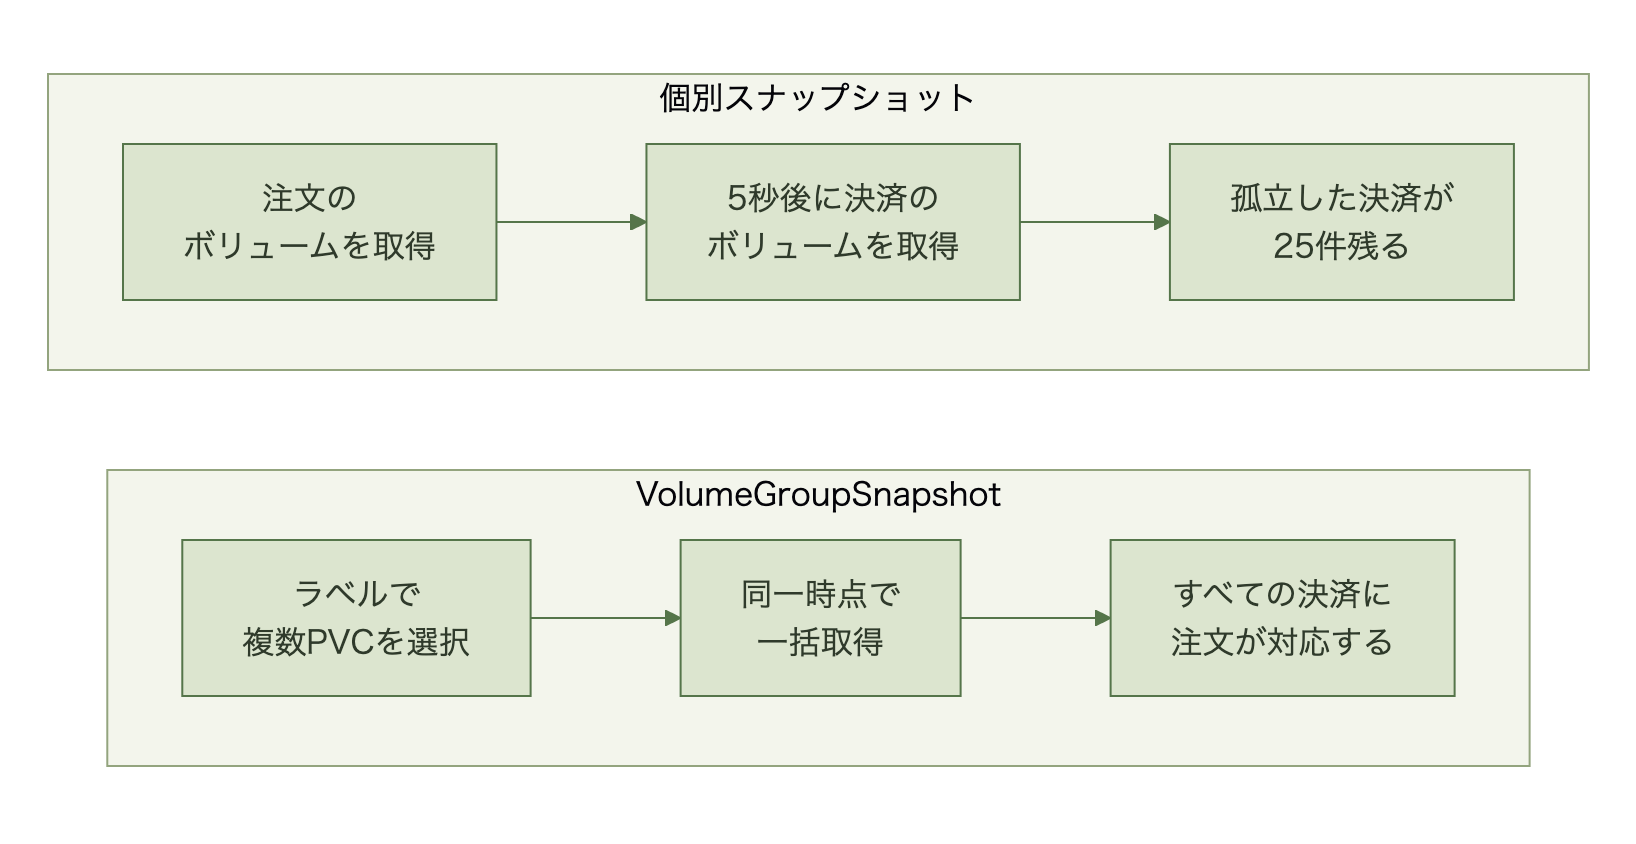
どの部品も故障していない。すべての操作が成功を報告し、それでも組み合わせた復旧ポイントは実在しなかった一瞬を指している。本番環境では、この5秒の差は100個のPVCを1つずつ処理していくバックアップツールそのものである[1]。個々のスナップショットのログを見ても検出できず、復元して整合性を確認するまで気づけない。
数千台規模のクラウドKubernetesクラスタでAI/ML基盤を運用し、GPU予算が前年から急増している情報システム部門のインフラ担当にとって、稼働率の実態は投資判断そのものを左右する数字になる。予算要求の起点になるのはGPU(画像処理[…]
VolumeGroupSnapshot APIはKubernetes 1.36で何を変えたか
Kubernetes 1.36でGAとなったVolumeGroupSnapshot APIは、ラベルセレクタで複数のPVCをまとめ、その集合に対してクラッシュ整合のスナップショットを取る[2]。ユーザーが作るオブジェクトは1つで、CSIドライバが受け取る要求も1つになる[1]。v1.27でアルファ、v1.32でベータ、v1.34で2度目のベータを経て2026年5月のGAに至っており、成熟に時間をかけた機能である[2]。検証チームが同じシナリオでグループスナップショットを使って復元すると、注文も決済も最後のコミットが109169で揃い、すべての決済に対応する注文があった[1]。
| 取得方法 | 最後にコミットされた注文 | 最後にコミットされた決済 | 対応する注文のない決済 |
|---|---|---|---|
| 個別スナップショット(5秒差) | 108352 | 108377 | 25件 |
| VolumeGroupSnapshot | 109169 | 109169 | 0件 |
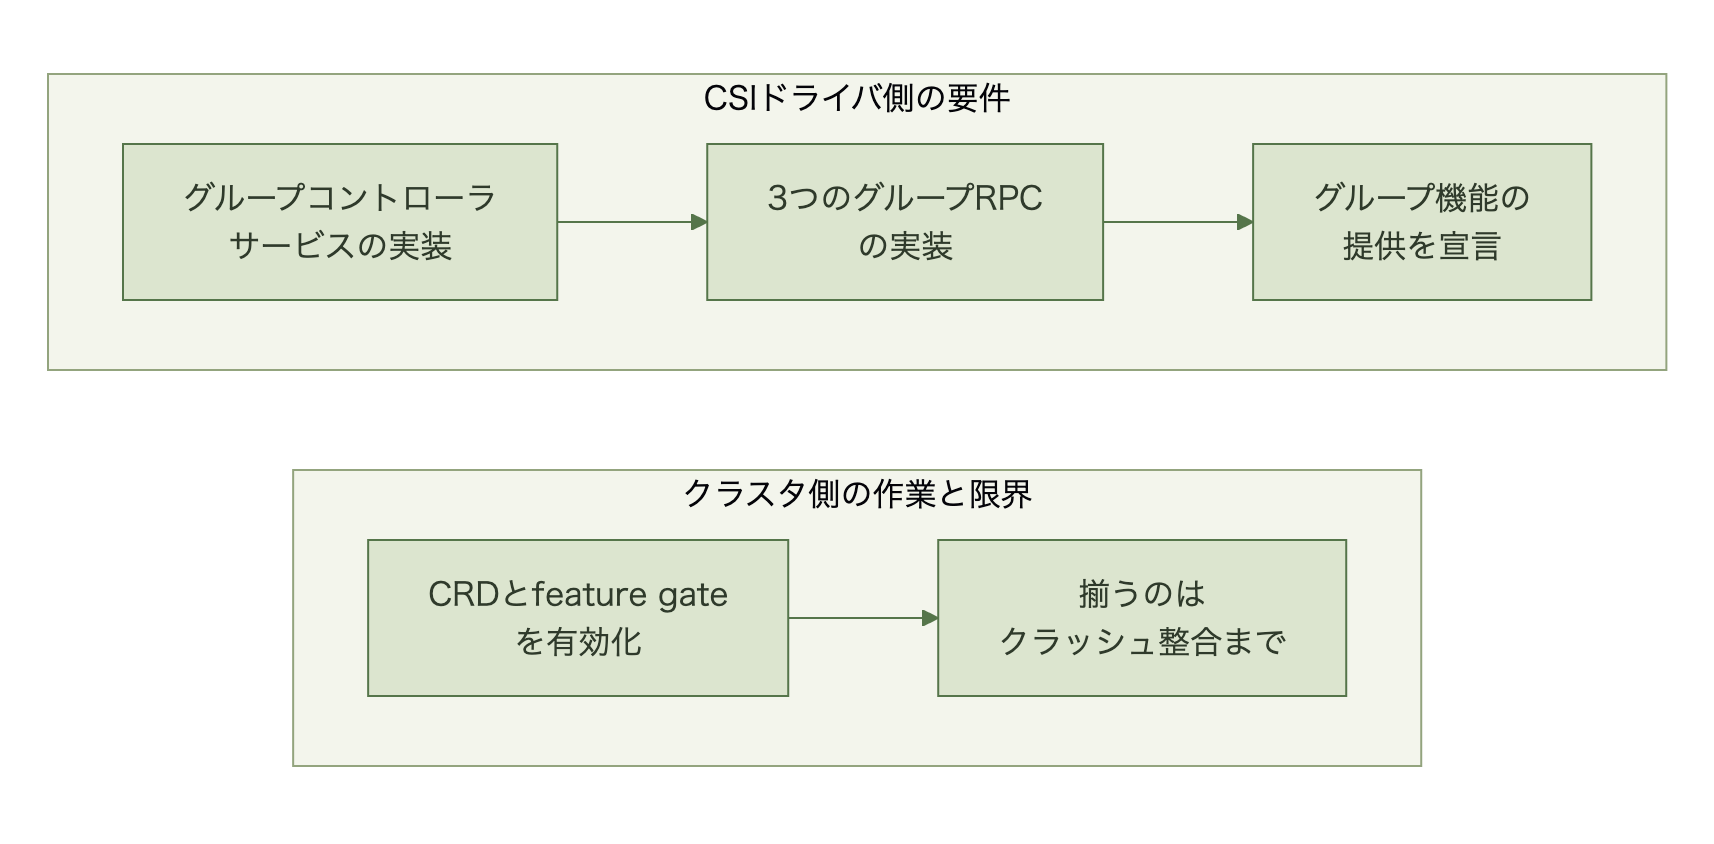
ただし検証は留保を並べている。対応はドライバごとで、通常のVolumeSnapshotに対応していることはグループスナップショットに対応している証拠にならない。CSIのグループRPCは別の実装だからである。2026年半ば時点で、ラボのために確認した主要クラウドのドライバの多くはこれを実装していない。スナップショットコントローラとCSIサイドカーのCRDとfeature gateは運用者が明示的に有効化する。そしてクラッシュ整合はアプリケーション整合ではない。このAPIが消すのはボリューム間の取得時刻のずれであって、データベースのフラッシュや静止点は別に用意することになる[1]。ラボ自体も、グループRPCを実装しているCSI hostpathテストドライバがメンバーのボリュームを順番に保存するため、デモを決定的にする目的で取得中は書き込みを止めている。ある時点を本当に保証する部分は本番用ドライバのストレージバックエンドが担う[1]。
自社のドライバが対応しているかは、公式ブログが挙げるベンダー側の要件で判断できる。グループコントローラサービスを実装し、CreateVolumeGroupSnapshot・DeleteVolumeGroupSnapshot・GetVolumeGroupSnapshotの3つのRPCを実装し、CREATE_DELETE_GET_VOLUME_GROUP_SNAPSHOTというグループコントローラ機能を追加していることが条件になる[2]。
対応状況を横断して調べられる場所は、今のところない。Kubernetes-CSIのドライバ一覧は、各ドライバが記入できる機能をRaw Block・Snapshot・Expansion・Cloning・Topologyと定めており、グループスナップショット対応は一覧の項目に入っていない[3]。使っているドライバのドキュメントを個別に読むことになる。
金融庁の監督指針が着眼点にしているのは訓練の定期実施である
復元の訓練が公的な文書で明文化されている例として分かりやすいのは、金融庁の監督指針である。「主要行等向けの総合的な監督指針」III-3-7-1-2のシステムリスクの着眼点には、(9)コンティンジェンシープランとして「コンティンジェンシープランに基づく訓練は、全社レベルで行い、共同センター等の外部委託先等と合同で、定期的に実施しているか」「業務への影響が大きい重要なシステムについては、オフサイトバックアップシステム等を事前に準備し、災害、システム障害等が発生した場合に、速やかに業務を継続できる態勢を整備しているか」が並ぶ[4]。プランの水準については、金融情報システムセンター編の手引書が客観的な根拠の例として名指しされている[4]。
着眼点が問うのは訓練を実施しているかと態勢を整備しているかであって、訓練の合格条件までは書かれていない。そこは各社が決める。ここまでの3つのシナリオが示したのは、その合格条件を「Podが起動した」ではなく「期待したデータが揃った」に置かないと、緑のダッシュボードが訓練の成果として残ってしまうということである。
同じ着眼点の(7)システム監査には「監査対象は、システムリスクに関する業務全体をカバーしているか」とある[4]。GitOpsのリポジトリとバックアップストアは別系統で、片方だけでは復旧しない。監査範囲を決める段階で、両方が入っているかは確認できる。
よくある質問(FAQ)
Q. バックアップログが「成功」なら安心していいですか。
A. いいえ。完了表示が示すのはバックアップ処理が完了したことまでで、アプリケーションが起動するか、期待したデータを含むかは示しません。定期的な復元テストが別途必要です。
Q. VolumeGroupSnapshotはすぐに使えますか。
A. CSIドライバがグループRPCを実装していることが前提です。2026年半ば時点で、検証チームが確認した主要クラウドのドライバの多くは未実装でした。ドライバ一覧に対応状況の項目がないため、使っているドライバのドキュメントで個別に確認します。
Q. VolumeGroupSnapshotを使えばデータベースの整合性は保証されますか。
A. 保証されるのはクラッシュ整合までです。複数ボリューム間の取得時刻のずれは消えますが、データベースのフラッシュや静止点は別に用意します。
Q. GitOpsを使っていればバックアップは不要ですか。
A. 不要にはなりません。GitOpsは宣言した構成を再現する仕組みで、保存されていたデータは別の保存先から戻します。
まとめ
バックアップの「完了」表示、GitOpsによる構成の復旧、個別スナップショットの取得時刻のずれ。3つとも、ログや画面表示だけを見ていると気づけない。Kubernetes 1.36でGAとなったVolumeGroupSnapshot APIは3つ目に効くが、CSIドライバがグループRPCを実装していることと、クラッシュ整合の先はアプリケーション側で用意することが前提になる。
手を動かす順番としては、まずバックアップの成功判定に転送バイト数の確認を足す。次に、一度もそのアプリケーションを動かしたことのない環境へ復元し、期待した中身と突き合わせる訓練を一度やって、そこまでの時間を計る。最後に、使っているCSIドライバがグループスナップショットのRPCを実装しているかをドキュメントで確認する。バックアップの「完了」は、復元の「成功」とは別の言葉である。
出典
[1] Kubernetes disaster recovery: Guidance from three reproducible failure scenarios (CNCF Blog, 2026-09-10)[2] Kubernetes v1.36: Moving Volume Group Snapshots to GA (Kubernetes Blog, 2026-05-08)
[3] Drivers – Kubernetes CSI Developer Documentation
[4] 主要行等向けの総合的な監督指針(III 主要行等監督上の評価項目)(金融庁)